Kling 4.0 — Нейросеть Kling 4.0 создаёт видео из текста, картинки и референсов, меняет готовые ролики и добавляет продолжение. Мы проверили пять режимов: ниже результаты, задания и настройки для повторения.
Gemini Omni 1.1 — Gemini Omni 1.1 Flash — видеонейросеть Google, вторая модель Omni: снимает ролики до 10 секунд со звуком и русской речью по тексту, картинкам и вашему видео. Помнит сохранённых героев и голоса, а для быстрых проб умеет 360p.
Seedance 2.0 Mini — Seedance 2.0 Mini — облегчённая нейросеть ByteDance для коротких роликов без звука: снимает видео от 4 до 15 секунд из текста, из картинки или по набору референсов в 480p или 720p. Удобна, чтобы недорого перебрать варианты сцены до финального запуска.
Veo 3.1 — Veo 3.1 — нейросеть Google для видео со звуком: снимает восьмисекундный ролик по описанию, по картинке, по референсам или между двумя заданными кадрами, и герои в нём говорят по-русски. Модели Lite, Fast и Обычная отличаются ценой и проработкой кадра.
Flux 3 Video — Flux 3 Video — видеонейросеть Black Forest Labs: снимает ролик на 5–20 секунд со звуком по описанию или по 1–10 картинкам. Сначала можно сделать дешёвый черновик, а удачный довести до HD или FHD с тем же сюжетом и движением.
Seedance 2.0 — Seedance 2.0 — нейросеть ByteDance для видео до 15 секунд: снимает ролик по описанию, по фото, по первому и конечному кадру или по набору референсов и переделывает готовое видео. Для снимков с лицами людей в форме есть модели Face.
Vidu Q4 — Vidu Q4 — видеонейросеть ShengShu Technology, которая оживляет одно фото в ролик со звуком или собирает сцену по 2–12 референсам героев и предметов. Задание понимает на русском, а голос героя можно задать своим MP3-файлом.
HappyHorse 1.1 — HappyHorse 1.1 — нейросеть Alibaba для коротких роликов со звуком: превращает описание, одну картинку или до девяти референсов в видео на 3–15 секунд. По сравнению с версией 1.0 у неё девять форматов кадра, включая 4:5 и 21:9, и задание до 5000 знаков.
Vidu Q3 Ad — Vidu Q3 Ad — нейросеть ShengShu Technology для рекламы: по фото товара и описанию снимает ролик на 3–16 секунд со звуком. В одну сцену она собирает до семи картинок — товар, героя и место, поэтому видео для товара получается без съёмки и монтажа.
Wan 2.6 Flash — Wan 2.6 Flash — быстрая версия видеомодели Wan 2.6 от Alibaba: оживляет картинку на 2–15 секунд или собирает ролик по пяти референсам, со звуком или без. Подойдёт, когда нужен короткий ролик точной длины или несколько планов в одном видео.
PixVerse C1 — PixVerse C1 — видеонейросеть AIsphere для постановочных сцен: снимает ролик до 15 секунд по тексту, из картинки, по 1–5 референсам героев и предметов или переходом между кадрами. Сама делит сцену на несколько планов и держит героя узнаваемым, звук добавляет по желанию.
Vidu Q3 Drama — Vidu Q3 Drama — нейросеть ShengShu Technology, которая снимает видео по сценарию: вы расписываете кадры и реплики, а героев, место действия и важные предметы задаёте картинками. Лица, одежда и обстановка в ролике остаются как на этих картинках, а планы сменяются в порядке сценария.
Как выбрать нейросеть
Видео по референсу — ролик, который нейросеть собирает по вашим образцам: вы загружаете фото героя, снимок товара или места, короткий ролик с нужным движением или запись голоса. Такой файл и называется референсом. В новом ролике сохраняются лицо, одежда, этикетка и интерьер, а что происходит в кадре, решает ваше задание. Так снимают серию роликов с одним персонажем, рекламу конкретного товара или сценку для сторис в знакомом месте.
От видео из фото это отличается тем, что картинка не становится первым кадром. Из нескольких картинок собирается новая сцена, которой не было ни на одной из них. Мы проверили это на трёх своих картинках в пяти нейросетях-лидерах. Сцену с первого раза собрали все пять, а различались они местом, этикеткой и речью: одна нейросеть придумала свою пекарню, другая не выговорила русскую фразу.
Героиня, банка и пекарня в пяти нейросетях
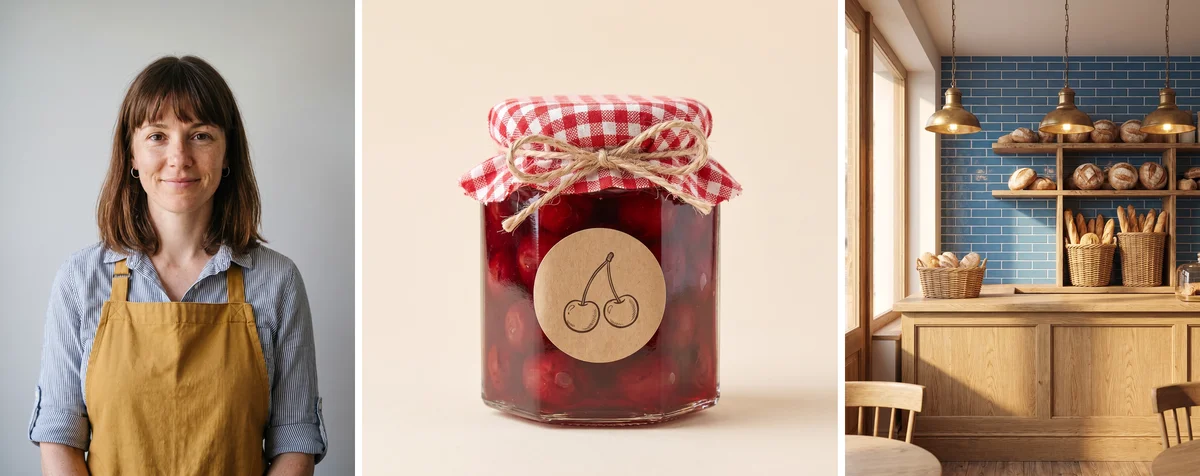
Исходники мы сгенерировали сами в Nano Banana Pro: женщина-пекарь, которой не существует, банка вишнёвого варенья с рисунком вместо надписи и пустая пекарня с голубой плиткой.
Задание у всех одно. Отличается только то, как в нём названы картинки: у каждой нейросети своя запись, о ней ниже. Все ролики на 6 секунд, 720p, вертикальные 9:16, со звуком.
Героиня с @image1 стоит за прилавком в пекарне с @image3. Она ставит на прилавок банку варенья с @image2, поворачивает её этикеткой к камере, улыбается и говорит по-русски: «Вишнёвое, сами варили. Попробуйте!» Камера медленно приближается. Реалистичная съёмка, тёплый утренний свет.
Героиню узнать можно везде: чёлка, веснушки, горчичный фартук, рубашка в полоску. Пекарню и банку ближе всех к картинкам перенесли Wan 3.0 Video Prime и Gemini Omni, с той же плиткой, латунными лампами и вишнями на этикетке. Лицо ближе всего к фото у Omni и Seedance 2.5, причём Seedance единственная по-настоящему выполнила «камера медленно приближается»: подвела камеру к крупному плану лица, и черты при этом не поплыли. Grok Video героиню сохранила, а пекарню придумала свою: серая плитка, полок больше, окна нет, вишни на этикетке перерисованы.
Речь мы проверяли распознаванием. Фразу слово в слово сказали четыре нейросети, а у Kling 3.0 вышло что-то вроде «вишня мы саби это сделать», хотя картинку она собрала точно. Всё сравнение обошлось нам в 458 ₽, больше половины из них пришлось на две самые дорогие нейросети, Seedance 2.5 и Wan 3.0 Video Prime.
Как собрать ролик из референсов на сайте
Откройте нейросеть по карточке выше. У большинства лидеров в поле Тип генерации нужно выбрать «Видео по референсам». У Grok Video такого пункта нет: там режим «Видео из изображений», и картинок в него можно загрузить до 7. У Gemini Omni режим называется «Видео». Загрузите файлы, в поле Задание (это и есть промпт) опишите сцену, выберите длительность, разрешение и пропорции кадра и нажмите Отправить. Цена видна на кнопке до запуска и меняется вместе с настройками. Разрешение 480p годится для проб, 720p — для телефона, 1080p и 4K — для большого экрана.
Готовый ролик появится под формой и в разделе Мои результаты, хранится 7 дней. Если сайт для вас новый, начните с инструкции по сайту.
Главное в задании: сказать, какой файл за что отвечает. Файлы нумеруются в порядке загрузки, а записывать номер нейросети просят по-разному:
в Seedance 2.5 и Seedance 2.0 Mini пишут @image1, @video1, @audio1, в Kling 3.0 — только @image1 и дальше по номерам, потому что видео и аудио в этом режиме она не берёт, в Vidu Q4 — @image1 и @audio1; можно набрать @ и выбрать файл из меню;
в Wan 3.0 Video и Wan 3.0 Video Prime называют словами: «изображение 1», «видео 1», «аудио 1»;
у Grok Video и Gemini Omni подсказки в форме нет; у нас сработали «с изображения 1» в Grok и @image1 в Omni.
С каких нейросетей начать
Seedance 2.5: больше всего референсов и образец движения
Seedance 2.5 от ByteDance вышла в конце июля 2026. Она принимает до 30 картинок, до 10 видео и до 10 аудиофайлов. Каждое видео и аудио длится от 2 до 30 секунд; все видео вместе — не больше 30 секунд, все аудио — тоже. Ролик выходит на 4–30 секунд, в 480p, 720p или 1080p. Платите за секунду: с видео-референсом ставка ниже, но к секундам ролика прибавляются секунды образца. Наши 5 секунд ролика с 6-секундным образцом посчитались как 11. Самая низкая ставка: от 8 ₽/сек..
Видео-референс есть не у всех нейросетей категории. Мы сняли в Grok Video 6-секундный ролик: парень в студии делает два шага, поворачивается и поднимает руки. Героиня повторила всё это за 5 секунд, уже в пекарне и в своём фартуке. С первого раза образец не приняли: у Grok он вышел 416×752, меньше 480p, а Seedance 2.5 берёт видео-референс в 480p, 720p или 1080p. Мы увеличили ролик до 720×1280, а деньги за отклонённый запуск вернулись. Сами разработчики в блоге ByteDance Seed пишут, что сложные движения и сцены с несколькими героями модель пока передаёт не всегда правдоподобно.
Слева образец движения, справа результат.
Героиня с @image1 в пекарне с @image2 повторяет движения из @video1: два шага вправо, поворот вокруг себя и руки вверх. Камера облетает её на полкруга, как в @video1. Лицо, причёска и одежда — как на @image1, фон — пекарня, а не студия.
Seedance 2.5 · 2 картинки и видео, 5 с, 720p · от 8 ₽/сек.
Grok Video: дёшево и до 30 секунд
Grok Video от xAI дешевле остальных лидеров: от 2 ₽/сек, самый короткий ролик у неё 6 секунд в 480p. В режиме «Видео из изображений» она берёт до 7 картинок, ролик тянется до 30 секунд, разрешение 480p или 720p.
Пекарню в сравнении Grok придумала свою, зато героиню держит долго. Мы расписали ролик на 20 секунд по отрезкам: открывает пекарню, раскладывает хлеб, ставит банку, встречает покупателя. Все четыре отрезка Grok выполнила по порядку, и героиня до конца осталась той же. От себя нейросеть добавила покупательницу и реплики «Доброе утро! Добро пожаловать в нашу пекарню», хотя речи в задании не было. Если слова не нужны, так и напишите: «без речи».
Один ролик на 20 секунд. 0–5 с: раннее утро, героиня с изображения 1 открывает дверь пекарни с изображения 3 и включает лампы над прилавком. 5–10 с: она достаёт из печи румяные караваи и раскладывает их по плетёным корзинам. 10–15 с: ставит на прилавок банку варенья с изображения 2 рядом с хлебом. 15–20 с: входит первый покупатель, героиня машет ему рукой и улыбается. Реалистичная съёмка, тёплый утренний свет.
Wan 3.0 Video Prime и Wan 3.0 Video: точнее всех переносят место
Wan 3.0 Video Prime от Alibaba вышла в августе 2026. В режиме «Видео по референсам» она принимает до 10 картинок, до 5 видео и до 5 аудио: каждый файл от 1 до 15 секунд, всего не больше 15. Ролик длится от 2 до 30 секунд. Цена за секунду зависит только от разрешения, звук на неё не влияет: от 4 ₽/сек.. У Wan 3.0 Video такие же лимиты, а секунда дешевле: от 3 ₽/сек.. Ещё обе умеют собрать ролик по документу (PDF, презентация, таблица) или по публичной странице, это пригодится для роликов-объяснений.
В сравнении Prime перенесла пекарню почти кадр в кадр. Потом мы проверили аудио-референс: записали в «Меге» фразу женским голосом и попросили героиню сказать этим голосом другую. Слова Wan произнесла чисто, но голос в ролике заметно выше, чем в образце, так что точной копии не ждите. Когда голос должен совпасть, надёжнее говорящее фото: там ваша запись идёт в ролик без изменений.
Образец голоса, который мы загрузили:
Героиня с изображения 1 стоит за прилавком в пекарне с изображения 2, смотрит в камеру и говорит по-русски голосом из аудио 1: «Хлеб только из печи, берите горячим!» Реалистичная съёмка, тёплый утренний свет.
Kling 4.0 принимает до 10 изображений, до 5 видеореференсов суммарной длиной не больше 30 секунд и до 3 аудиореференсов по 5–30 секунд каждый. Для звука в форме три отдельных поля. В задании укажите, что взять из @Image1, @Video1 и @Audio1; номера идут по заполненным файлам каждого типа. Результат длится 3–30 секунд, с выбором 720p или 1080p. При наличии видео появляется переключатель сохранения его звука.
Kling 3.0: несколько планов и 4K
Kling 3.0 принимает до 7 картинок-референсов (JPG или PNG, от 300×300) и делает ролик на 3–15 секунд в 720p, 1080p или 4K. Главное в её форме — поле Сцены. В режиме «Один ролик» получается один план, в «Умном планировании» нейросеть сама режет задание на планы, а в «Своих сценах» длительность и задание каждой сцены пишете вы. В поле Элементы загружают картинки героя или предмета, который должен остаться узнаваемым. Цена — от 7 ₽/сек.; в 720p и 1080p со звуком (переключатель Нативное аудио) секунда дороже.
В «Умном планировании» мы расписали три сцены на 10 секунд: общий план у полок, крупно руки с банкой, героиня смотрит в камеру. Получилось ровно три плана, героиня и банка в каждом одинаковые. Русскую фразу Kling и здесь не выговорила, поэтому звук в этом примере мы убрали.
Три сцены с одной героиней. Сцена 1: героиня с @image1 раскладывает караваи по полкам в пекарне с @image3, общий план. Сцена 2: крупный план её рук, она ставит банку варенья с @image2 на прилавок. Сцена 3: героиня улыбается в камеру и говорит по-русски: «Ждём вас с утра!»
Kling 3.0 · «Умное планирование», 10 с, 720p, звук убран · от 7 ₽/сек.
Gemini Omni: двое людей в одной сцене
Gemini Omni от Google принимает до 7 картинок и исходный ролик до 30 секунд, из которого берётся фрагмент до 10 секунд. Платите не за секунду, а за ролик на 4, 6, 8 или 10 секунд: от 60 ₽. В режиме Персонаж нейросеть по одной картинке и описанию создаёт героя, и потом его можно добавить в новый ролик через поле Персонажи, до трёх в одном. Лимит у Omni общий: картинки, по 2 за каждое видео и персонажи вместе дают не больше 7.
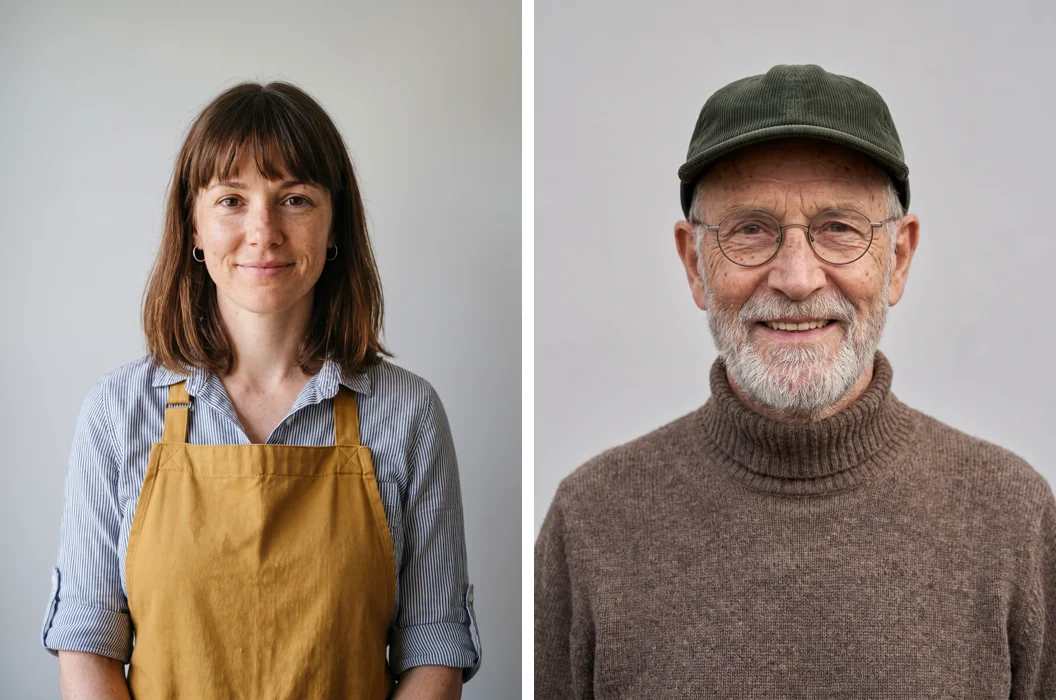
Для примера мы дали ей двух выдуманных людей, продавщицу и пожилого покупателя, и ту же пекарню. Оба узнаются, а реплики «Ваш любимый, ещё тёплый» и «Спасибо, дочка!» распознались слово в слово.
@image1 — продавщица за прилавком в пекарне с @image3. @image2 — пожилой покупатель, он входит и подходит к прилавку. Она протягивает ему бумажный пакет с багетом и говорит по-русски: «Ваш любимый, ещё тёплый». Он улыбается и отвечает: «Спасибо, дочка!» Реалистичная съёмка, тёплый утренний свет.
Gemini Omni 1.1 новее и дешевле Omni при той же длине ролика, а задание в ней может быть до 20 000 знаков. У Seedance 2.0 Mini та же запись @image1 и те же три вида файлов, что у Seedance 2.5, а секунда дешевле: ролик на 4–15 секунд в 480p или 720p. Наш ролик из сравнения в 480p вышел узнаваемым, но без звука: переключателя звука в её форме нет, и героиня шевелит губами молча.
Seedance 2.5 Flash ByteDance выпустила 12 ноября 2026 года как быструю облегчённую версию Seedance 2.5. Референсов она берёт меньше: до 10 картинок, 5 видео и 5 аудио, каждое видео от 2 до 30 секунд, все вместе не длиннее 30 секунд. В задании файлы называют @Image1, @Video1, @Audio1. Ролик выходит на 4–30 секунд в 480p или 720p, 1080p в ней нет. В нашей пробе сюжет и движение камеры она взяла из видео-референса, а героя с картинки.
Третья Omni, Gemini Omni 1.2 Flash, принимает только картинки, зато до 10 штук, и снимает от 3 до 15 секунд в разрешении от 360p до 4K. Видео и аудио в референсы здесь не загрузить. В отличие от старших Omni, платите за секунду: от 3 ₽/сек. В нашей пробе женщина и чемодан со снимков перенеслись на вокзал узнаваемо, а на снимки мы сослались словами «с первого снимка» и «со второго снимка». С первого раза модель добавила в кадр второй чемодан, поэтому мы переписали задание и уточнили «единственный» и «других чемоданов в кадре нет». Катить его героиня всё равно не стала, она держит чемодан за ручку. Обе картинки нарисованы нейросетью, героиня выдуманная.
Женщина с первого снимка идёт по перрону старого вокзала под дождём и катит за ручку единственный чемодан со второго снимка, других чемоданов в кадре нет. Вдали приближается поезд. Камера движется рядом с ней. Слышно дождь, стук колёсиков по плитке и далёкий гудок поезда. Без надписей и логотипов.
У Seedance 2.0 до 9 картинок-референсов, две модели (быстрая Fast и обычная) и правка готового ролика до 15 секунд. Wan 2.7 Video в режиме «Видео по референсам» принимает одну картинку и до 4 роликов, ролик на 2–10 секунд, а ещё умеет править и продлевать видео. У Wan 2.6 Flash до 5 референсов (видео среди них до 3), ролик на 5 или 10 секунд и режим «Несколько кадров». Veo 3.1 от Google умеет работать по референсам в вариантах 1 и 3 поля Версия: до 3 картинок, разрешение до 4K.
Высокое разрешение и новые модели
MiniMax H3 снимает ролик на 5–15 секунд: в режиме «Обычный» до 2K, в «Дешёвом» до 1080p и только 16:9 или 9:16. Кроме картинок она принимает аудио, а в «Обычном» ещё и видео; одно аудио не сработает, а каждая секунда видео-референса добавляется к цене. HappyHorse 1.1 берёт до 9 картинок и снимает 3–15 секунд в 720p или 1080p. PixVerse C1 умеет и референсы, и переход между первым и последним кадром, звук добавляет по желанию, разрешение от 360p до 1080p. Flux 3 Video собирает ролик на 5–20 секунд из 1–10 картинок: сначала можно сделать дешёвый черновик, а удачный потом довести до HD или FHD.
Muse Video: сцена из картинок за одну цену
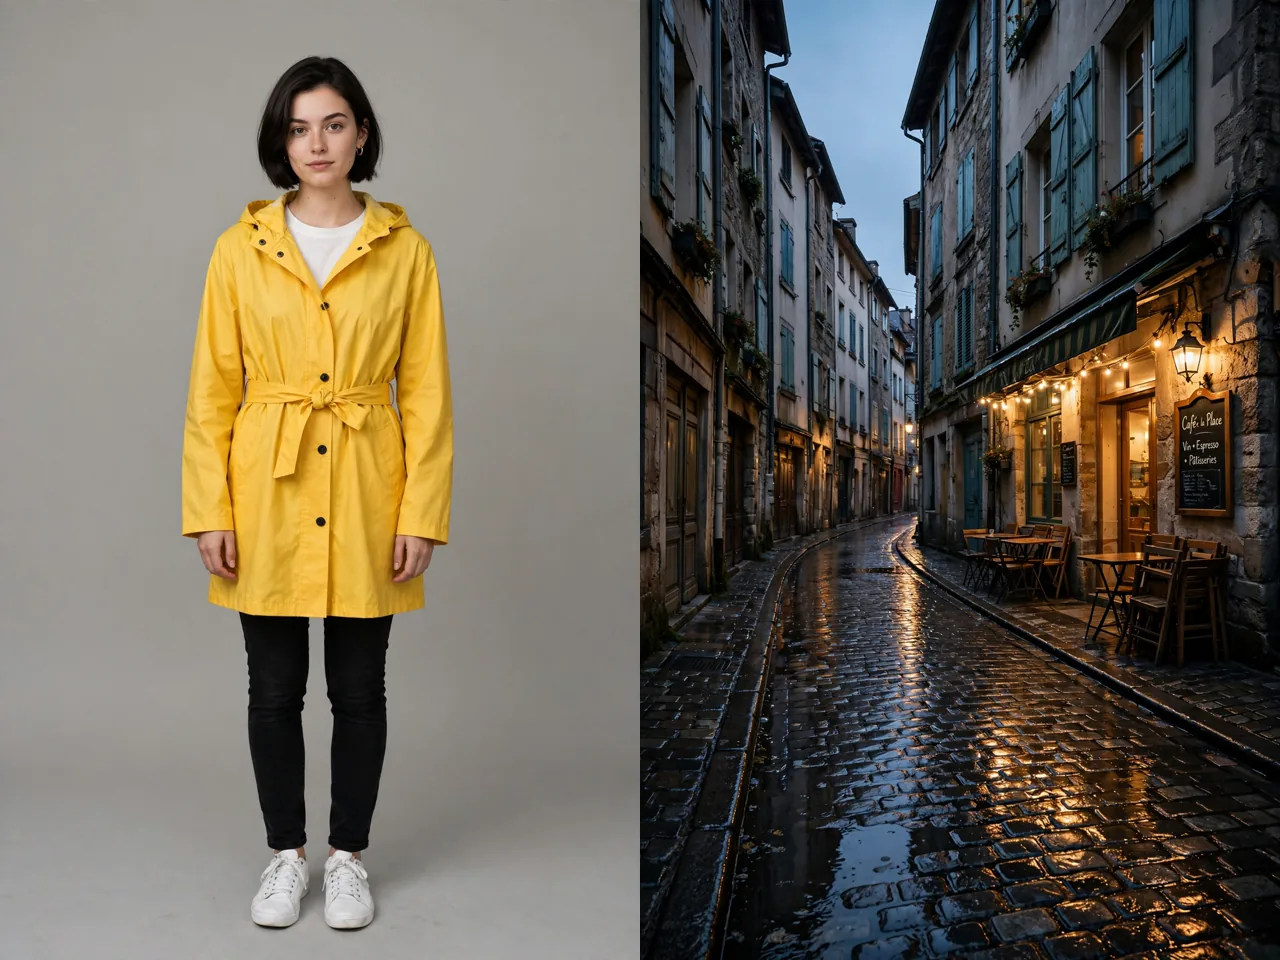
Meta Muse Video от Meta (признана экстремистской организацией и запрещена в РФ) появилась на сайте в ноябре 2026 года. Она берёт от 1 до 9 картинок, а видео и аудио не принимает. Ролик всегда около 10 секунд в 720p и со звуком, а формат кадра можно оставить «Как на референсах» или выбрать один из семи. Цена не зависит от числа картинок: 5 ₽. Мы дали ей выдуманную девушку и пустую вечернюю улицу, обе картинки сделаны в Meta Muse Image.
Девушка с первой картинки в жёлтом плаще идёт по мокрой улице со второй картинки, держит стаканчик кофе, камера едет перед ней, огни кафе отражаются в брусчатке, звучат шаги и лёгкая городская музыка
Стрижка, плащ с поясом и кеды совпали с референсом, улица узнаётся по вывескам и брусчатке. С тремя картинками (та же девушка, пожилой мужчина и корги) модель тоже свела всех в одну сцену и никого не перепутала, только движение упростила: корги шёл на поводке, а не бежал впереди, как в задании. Первым кадром референс не становится, модель берёт с него внешность и обстановку.
Vidu Q4: голоса героев из MP3
Vidu Q4 от ShengShu вышла 7 октября 2026 года. Она принимает до 12 картинок и до трёх голосов в MP3 по 3–12 секунд, ролик длится 3–16 секунд в качестве от 540p до 4K, формат кадра — 16:9, 9:16, 4:3, 3:4 или 1:1, звук выключается переключателем Со звуком. Отдельного режима нет: две картинки и больше или хотя бы один голос сами включают видео по референсам, а одна картинка без голоса станет первым кадром. Цена за секунду зависит только от качества: от 8 ₽/сек..
Мы дали ей трёх героев: выдуманного мастера, женщину в жёлтом дождевике и ламповый приёмник, а ещё два синтетических голоса. Каждому человеку назначили свой голос через @audio1 и @audio2.
Антикварная лавка. @image1 стоит за прилавком, на прилавке @image3. Входит @image2, видит приёмник и говорит по-русски голосом @audio2: «Ой, какой красивый! Он правда ещё работает?» @image1 улыбается и отвечает голосом @audio1: «Конечно. Сейчас включу.» Он поворачивает ручку, начинает играть музыка. Камера переходит с одного героя на другого.
Vidu Q4 · 3 картинки и 2 голоса, 1080p, 10 с, 16:9 · от 8 ₽/сек.
Сцену Q4 сама разбила на три плана: общий, крупный мастера и снова двоих у приёмника, и у каждого героя свой голос. Но по-русски модель не говорит: реплики похожи на русскую речь по ритму и интонации, а слов в них не разобрать. Русский текст лучше записать отдельно и подогнать губы в липсинке. Ждать пришлось долго, десять секунд в 1080p шли около 17 минут.
Agnes Video 2.5: речь из вашей записи
Agnes Video 2.5 от Agnes AI появилась на сайте в октябре 2026 года. В режиме «Видео по референсам» она берёт до 5 картинок и до 3 аудиозаписей в MP3 или WAV, записи вместе не длиннее 12 секунд. Видео-референсов она не принимает. Хватит и одного файла, даже одной записи без картинок: героя тогда модель придумает по заданию. Ролик длится 4–12 секунд в 720p, 1080p или 2K, звук в нём есть всегда. Мы дали ей портрет выдуманного пасечника и восьмисекундную речь выдуманного экскурсовода, озвученную в Qwen3 TTS.
Мужчина с изображения в роли экскурсовода стоит у автобуса на площади перед дворцом, обращается к туристам и говорит голосом и словами из референс-аудио. Утро, мягкий свет, камера на уровне глаз.
Agnes Video 2.5 · Картинка и аудио, 16:9, 720p, 8 с · от 3 ₽/сек.
Шляпа и борода с портрета на месте, а распознавание речи нашло в ролике все слова записи: «Доброе утро. Через 10 минут наш автобус отправится в Петергоф. Дорога займёт около часа». У Vidu Q4 запись — только образец голоса, слова там берутся из задания. Agnes произносит слова самой записи. Насколько тембр совпал с файлом, мы на слух не сверяли: распознавание проверяет только слова. Платите за секунды, ставка зависит от разрешения: от 3 ₽/сек..
Для особых задач
В Pika 2.2 режим Scenes собирает сцену из 2–5 картинок (точно или свободнее), а Pikaframes делает переходы между ключевыми кадрами, до 25 секунд. Vidu Q3 Drama работает от сценария до 5000 знаков и ассетов: персонажей, мест и предметов, до 14 штук. Vidu Q3 Ad снимает рекламный ролик на 3–16 секунд по 1–7 фото товара, со звуком.
Таблица: сколько файлов и какой длины ролик
В таблице лидеры и заметные нейросети категории, остальные видны карточками выше. Цена указана за самые дешёвые настройки.
Если нужен один герой в серии роликов и речь по-русски, берите Seedance 2.5 или Gemini Omni: лицо у них ближе всего к фото.
Если важнее всего место или товар, начните с Wan 3.0 Video Prime, а ради цены переходите на Wan 3.0 Video с той же формой.
Чтобы герой повторил движение или ход камеры из готового ролика, подойдёт Seedance 2.5 с видео-референсом.
Длинный ролик за небольшие деньги даст Grok Video: до 30 секунд одним куском. Если хватает ролика около 10 секунд в 720p, прикинуть сцену из нескольких картинок ещё дешевле выйдет в Meta Muse Video.
Несколько планов в одном ролике или 4K умеют Kling 3.0 и Vidu Q4; русский голос у обеих лучше накладывать отдельно.
Двоих или троих людей в кадре лучше отдать Gemini Omni.
Сцена с героями по картинкам и голосами из MP3-образцов (без русской речи) или ролик до 4K: Vidu Q4.
Если герой должен произнести готовую русскую запись не длиннее 12 секунд, берите Agnes Video 2.5.
Для рекламы по готовым фото товара есть Vidu Q3 Ad, а для ролика в 2K — MiniMax H3 в режиме «Обычный».
Каким должен быть референс
Одна вещь на файл: героиня отдельно, товар отдельно, место отдельно. Так проще и назвать каждую в задании.
Лист персонажа (одна картинка, где герой нарисован в нескольких позах и ракурсах) хорош для картинок, но в видео может навредить: когда мы готовили другую статью, Kling 3.0 по такому листу поставила в кадр сразу нескольких одинаковых героев. Для видео лучше одно чёткое фото.
Лицо крупно, свет ровный, фон простой: чем меньше деталей лица видно на фото, тем больше нейросеть дорисовывает сама.
Назовите в задании роль каждого файла: «героиня с @image1», «банка с @image2». Если не уточнить, из картинки может перейти лишнее, например фон с фото героя.
Текст не должен спорить с картинкой. Если на фото рубашка в полоску, не пишите «в белой футболке»: какая-то из подсказок проиграет.
Видео-референс берите не меньше 480p, лучше 720p, и обрежьте до нужного движения. В Seedance 2.5 и MiniMax H3 его секунды входят в цену.
Вопросы
Как придумать героев и снять с ними несколько серий, мы разобрали в инструкции «Сериал с помощью нейросети», а рекламный ролик по шагам — в статье о рекламном видео. Если нужно перенести движение из готового ролика на другого героя или заменить человека в видео, загляните в раздел «Видео из видео».