OmniHuman — нейросеть ByteDance, которая превращает одно фото и запись голоса в видео: человек на снимке говорит или поёт ваши слова, двигает губами, бровями и головой. На сайте три версии: OmniHuman 2.0, OmniHuman 1.5 и OmniHuman 1.0. Две пробы мы сделали в 1.5 и 1.0 с одинаковыми фото и записями, чтобы понять, за что 1.5 берёт больше. Третью, про жесты, только в 1.5. Версии 2.0 досталась своя глава: в ней можно словами попросить жест, и её мы сравнили с 1.5 на одном портрете.
Всё для проб сделали здесь же, на сайте. Портреты и енота нарисовала Nano Banana Pro, речь озвучила Мега, песню написал Suno. Людей на фото не существует.
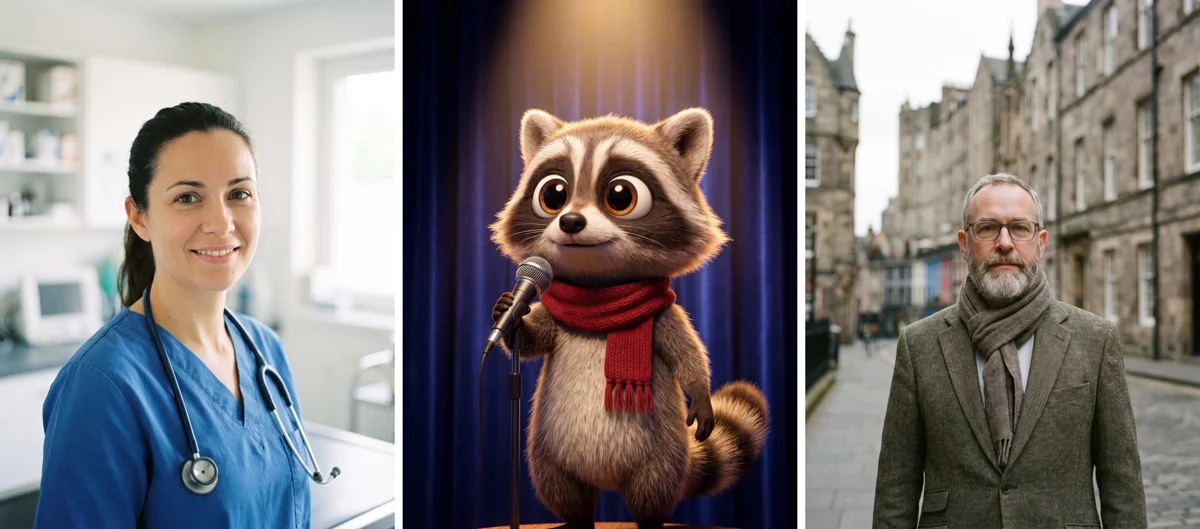
Первая проба: ветеринар Ольга говорит «Добрый вечер, я Ольга, ветеринар. Кот чихает уже третий день? Не пугайтесь, чаще всего это обычная простуда».
OmniHuman 1.0 · ролик 544×720 · 20 ₽/сек.
OmniHuman 1.5 · ролик 834×1104 · 35 ₽/сек.
Губы попадают в слова у обеих, на словах «Кот чихает уже третий день?» обе поднимают брови. Повороты головы совпадают почти кадр в кадр. Разница в мелочах: 1.0 чаще щурится, а ролик у неё меньше по размеру, 544×720 точек против 834×1104, поэтому мягче в деталях. На телефоне этого почти не видно.
Первую версию ByteDance показала в феврале 2025 года. По словам разработчиков, ей подходит фото любого плана, от лица крупным планом до человека в полный рост, а вместо речи можно загрузить песню.
Версию 1.5 ByteDance представила в августе 2025 года. Она устроена сложнее: одна её часть разбирает смысл сказанного, другая рисует движение. Поэтому жесты и мимика должны следовать за смыслом слов, а не за одной громкостью голоса. Разработчики обещают у 1.5 ещё текстовые подсказки и сцены с несколькими героями, но в форме 1.5 на сайте нет ни поля для подсказки, ни выбора, кто из героев говорит. Поле для подсказки появилось только в версии 2.0. Подробного описания 2.0 от разработчика мы не нашли, поэтому о ней судим по своим пробам.
Форма у 1.5 и 1.0 одинаковая: поле Фото (JPG, PNG, WebP или снимок с iPhone в HEIC) и поле Аудио (MP3, WAV, M4A и другие), по одному файлу. Поля Задание, куда пишут, что должно происходить в кадре, у них нет: всё поведение нейросеть берёт из звука. Запись — до 10 минут. У 2.0 те же Фото и Аудио плюс Задание, а запись нужна от 4 секунд до 5 минут. Пропорции ролика повторяют фото, вертикальный снимок даст вертикальное видео, а размер ролика не выбирается. Звук из записи уже вшит в видео.
Платите за каждую секунду записи, неполная секунда считается целой. Цена видна на кнопке Отправить до запуска. Как устроены запуски и где потом искать ролик, рассказывает инструкция по сайту.
Вторая проба — мультяшный енот в красном шарфе. Вместо речи загрузили кусок песни Suno длиной 7,85 секунды, с музыкой, отдельно голос не вырезали. Енот поёт: «Я енот в красном шарфе, я пою на сцене вам».
OmniHuman 1.0 · песня 7,85 с · 20 ₽/сек.
OmniHuman 1.5 · песня 7,85 с · 35 ₽/сек.
Здесь 1.5 живее. На словах «я пою на сцене вам» енот отводит свободную лапу в сторону, как артист перед залом, и покачивается всем телом. В 1.0 двигаются только голова и мордочка, лапы стоят на месте, а пару раз енот сонно прищуривается. Мультяшного героя обе версии не испортили: шерсть, шарф и микрофон остались как на картинке.
Жесты — главное, что разработчики обещают в 1.5, поэтому мы проверили их отдельно, на экскурсоводе. На фото он снят по пояс, руки за краем кадра, а в записи говорит: «Посмотрите направо: вот этот дом построили в тысяча восемьсот девяносто первом году. А теперь налево!»
OmniHuman 1.5 · запись 7,7 с · 35 ₽/сек.
На словах «вот этот дом» экскурсовод поднимает обе руки в кадр и разводит их, пальцы на месте, по пять на каждой. Направо при этом не показывает: жест вышел общий, «рассказывающий», а не указание. Попросить нужное движение словами в 1.5 нельзя, а в 2.0 можно: похожую задачу с картиной мы разобрали в главе о ней ниже. Другие нейросети с полем Задание собраны в разделе говорящего фото. Там же версия 1.5 стоит в сравнении с пятью другими нейросетями на одном портрете.
На крупных портретах рук у нас не появилось. Так устроен и готовый пример со страницы OmniHuman 1.5: портрет девушки по грудь нарисовала GPT Image 2, а запись стихотворения перед загрузкой очистили от шума в ElevenLabs Audio Isolation. Девушка читает с паузами, наклоняет голову и несколько раз прикрывает глаза.
OmniHuman 1.5 · запись 8 с · 35 ₽/сек.
Главное, что изменилось в 2.0, — поле Задание. В нём своими словами описывают мимику, жесты, настроение и движение камеры, до 2000 знаков, по-русски тоже можно. Поле необязательное: пустым оно оставляет выбор движений нейросети, как в прошлых версиях. Героев для этих проб мы тоже выдумали: портреты нарисовала GPT Image 2, голоса прочитала ElevenLabs v4.
Одну и ту же ведущую новостей с одной записью на 10 секунд мы запустили дважды. Первый раз поле Задание оставили пустым, во второй написали:
Ведущая говорит уверенно и доброжелательно, на словах о парке слегка разводит руками, в конце улыбается в камеру. Камера неподвижна.
OmniHuman 2.0 · без задания · 15 ₽/сек.
OmniHuman 2.0 · с заданием · 15 ₽/сек.
С пустым полем руки весь ролик лежат на столе. С заданием на пятой секунде, на словах о парке, ведущая разводит ладони, а заканчивает с улыбкой. В 1.5 и 1.0 так не выйдет: там жест появится или нет по воле нейросети.
Для сравнения версий мы взяли портрет библиотекаря, который рисовали для статьи об OmniHuman 1.5, и её фразу: «Здравствуйте! Книгу продлили? Жду вас в пятницу». Запись длится 3,8 секунды, а 2.0 принимает от четырёх, поэтому для неё в конец добавили полсекунды тишины. Поле Задание оставили пустым, больше ничего не меняли.
OmniHuman 1.5 · запись 3,8 с · 35 ₽/сек.
OmniHuman 2.0 · запись 4,3 с, без задания · 15 ₽/сек.
Обе версии на «жду вас» зовут жестом, но по-разному. В 1.5 женщина протягивает одну руку, и улыбка с фото у неё уходит, лицо становится деловым. В 2.0 она раскрывает обе ладони и улыбается почти весь ролик, как на снимке. Выходит, и без задания 2.0 жестикулирует не хуже 1.5, а держит лицо ближе к исходнику.
Экскурсовод из главы про 1.5 жест развёл, но направо не показал. Для 2.0 мы поставили похожую задачу: экскурсовод стоит перед картиной и 10 секунд рассказывает о ней. В задании написали:
Экскурсовод говорит спокойно, на словах «обратите внимание на эту картину» поворачивается и показывает рукой на картину за спиной.
OmniHuman 2.0 · фото 3:4, запись 10 с, с заданием · 15 ₽/сек.
Женщина поворачивается к раме и показывает на полотно, то есть просьбу выполнила. Но жест начался на четвёртой секунде, когда нужная фраза уже прозвучала. Привязка к словам в задании работает примерно, а не с точностью до слова.
| Нейросеть | Цена | Размер ролика из фото 3:4, точек | Что двигалось в наших пробах | Ждали ролик на 8 с |
|---|---|---|---|---|
| OmniHuman 2.0 | 15 ₽/сек. | 834×1112 | Лицо, голова, руки, жест по заданию | 3,5–5,5 мин |
| OmniHuman 1.5 | 35 ₽/сек. | 834×1104 | Лицо, голова, руки и лапы | 3,5–4 мин |
| OmniHuman 1.0 | 20 ₽/сек. | 544×720 | Лицо и голова | 2–2,5 мин |
Начинать теперь стоит с OmniHuman 2.0. Секунда у неё дешевле, чем у 1.5 и 1.0, и только в ней жест, улыбку или поворот к предмету можно попросить в поле Задание. На библиотекаре она и без подсказки сыграла не хуже 1.5. Ждать ролик, правда, бывает дольше, см. таблицу.
Прошлые версии пригодятся, когда запись длиннее 5 минут: 1.5 и 1.0 принимают до 10. Если в кадре видно тело (песня, выступление, рассказ с жестами), из них берите 1.5. Если крупное лицо и человек просто говорит (поздравление, объявление), хватит 1.0: на ветеринаре она почти не уступила 1.5. Фразу короче 4 секунд 1.5 и 1.0 примут как есть, а для 2.0 добавьте в конец тишину, как мы с библиотекарем.
Ни в одной версии на сайте нельзя выбрать, кто из двоих на фото говорит. Для диалога двух людей есть отдельные нейросети в том же разделе говорящего фото. Если у вас готовое видео и в нём надо заменить речь, нужен липсинк. Если записи голоса нет, её сделают нейросети озвучки текста.
Пробы версий 1.5 и 1.0 (три картинки, две озвучки, песня и пять роликов) обошлись нам в 1 273 ₽, почти всё ушло на ролики.
Статья обновлена 16 октября 2026 г.