Vidu Q4 — видеонейросеть ShengShu Technology, которая оживляет одно фото в ролик со звуком или собирает сцену по 2–12 референсам героев и предметов. Герои говорят по-русски, а голос можно задать своим MP3-файлом.
Коротко
- Разработчик
- ShengShu Technology (Китай), предварительная версия Q4 Preview вышла 7 октября 2026 года
- На входе
- задание до 5000 знаков, от 1 до 12 картинок JPG, PNG, WebP или HEIC и по желанию до 3 голосов в MP3 по 3–12 секунд
- На выходе
- ролик MP4 от 3 до 16 секунд, 540p, 720p, 1080p, 2K или 4K; из одного фото — в его пропорциях, по референсам — 16:9, 9:16, 4:3, 3:4 или 1:1
- Звук
- реплики и звуки сцены; из одного фото всегда со звуком, по референсам звук можно выключить
- Русский язык
- понимает задание на русском и говорит по-русски; с голосом из файла в наших пробах — почти слово в слово
- Режим
- выбирается сам: одно фото — первый кадр, несколько фото или голос — видео по референсам
- Цена
- от 8 ₽/сек.
Что умеет: пять проб с героями и голосами
Все ролики ниже мы сняли для этой страницы, задания писали по-русски. Людей на исходниках нарисовали нейросети сайта, это выдуманные персонажи. Голоса тоже синтетические: две короткие фразы мы озвучили в MiniMax Speech 2.8 и загрузили в поле Голоса как образцы.
Метки @image1 и @image2: кто где стоит
Первым делом мы проверили, понимает ли модель ссылки на картинки. Загрузили два референса: мятный ламповый приёмник и рыжего кота, оба на белом фоне. В задании назвали их только метками, без описаний: «слева стоит @image1, справа сидит @image2». Метку не нужно печатать руками: наберите в поле Задание символ @, и появится список загруженных файлов с миниатюрами.
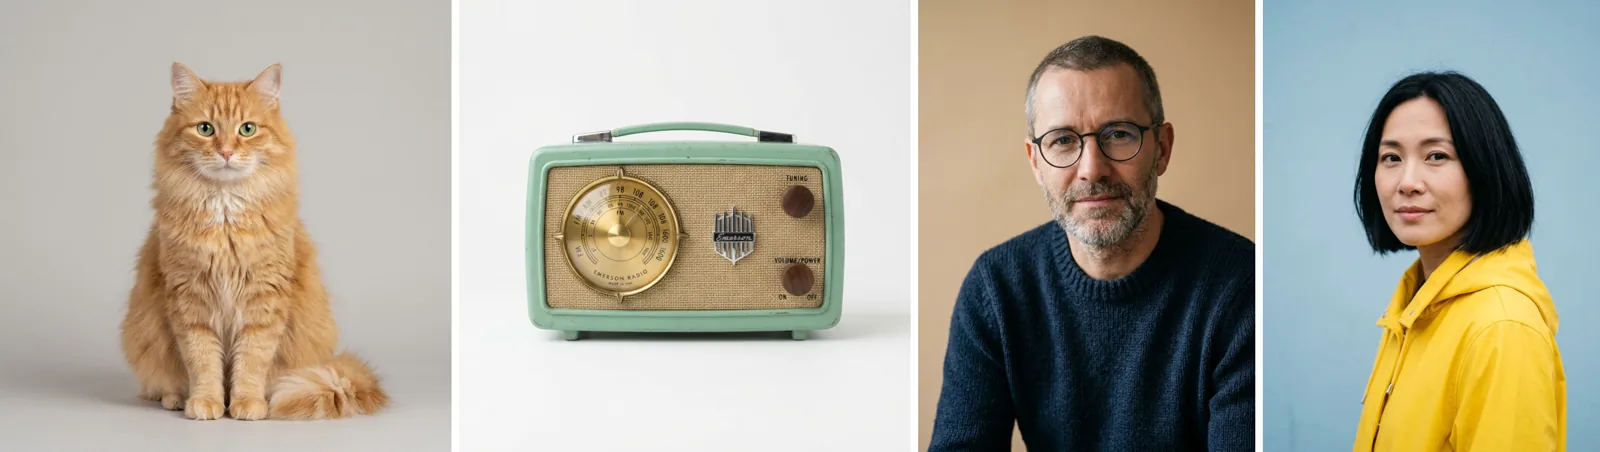
На деревянном столе у окна: слева стоит @image1, справа сидит @image2. @image2 медленно тянется лапой к ручке настройки, из динамика начинает тихо играть джаз, @image2 удивлённо наклоняет голову. Тёплый утренний свет, камера неподвижна.
по референсам: 2 картинки, 540p, 5 с, 16:9
Приёмник встал слева, кот справа, и это тот же приёмник: золотая шкала, деревянные ручки, мятный корпус. Кот дважды трогает ручку лапой и под конец смотрит в камеру. Удивлённого наклона головы мы так и не увидели, а тихая музыка в ролике есть.
Своя реплика своим голосом
Поля Голоса у Vidu Q3 нет, в Q4 оно появилось. Сюда загружают MP3 с голосом, а в задании пишут, кто каким голосом говорит: голосом @audio1. Мы дали портрет выдуманного мастера, фото того же приёмника и восьмисекундную запись мужского голоса. Фраза в задании была другой, не той, что звучит в образце.
@image1 сидит в маленькой мастерской за верстаком, заваленным лампами и проводами, и бережно протирает @image2. Потом поднимает взгляд в камеру и говорит по-русски голосом @audio1: «Этому приёмнику шестьдесят лет, а поёт как новый.»
Тёплый свет настольной лампы, камера медленно приближается.
по референсам: 2 картинки и 1 голос, 720p, 8 с, 16:9
Распознавание речи записало реплику без единой ошибки: «Этому приёмнику шестьдесят лет, а поёт как новый». Борода, очки и тёмный свитер как на портрете, на столе лампочки и провода. Похож ли тембр на образец, распознавание не скажет, это лучше послушать самому.
Диалог двух героев
Дальше мы усложнили задачу: три картинки (мастер, женщина в жёлтом дождевике, приёмник) и два голоса, мужской и женский. Каждому герою в задании назначили свой.
Антикварная лавка. @image1 стоит за прилавком, на прилавке @image3. Входит @image2, видит приёмник и говорит по-русски голосом @audio2: «Ой, какой красивый! Он правда ещё работает?» @image1 улыбается и отвечает голосом @audio1: «Конечно. Сейчас включу.»
Он поворачивает ручку, начинает играть музыка. Камера переходит с одного героя на другого.
по референсам: 3 картинки и 2 голоса, 1080p, 10 с, 16:9
Q4 сама разбила десять секунд на три плана: общий с обоими героями, крупный мастера и снова двое у приёмника. Обе реплики на месте, в распознавании ошиблось одно слово: вместо «работает» вышло что-то вроде «раборе». Вход героини модель пропустила: с первого кадра она уже стоит у прилавка.
Фото как первый кадр
Если загрузить одну картинку и ни одного голоса, Q4 работает иначе: картинка становится первым кадром, а пропорции ролика повторяют её. Для сравнения с Vidu Q3 мы взяли ту же кухню с чайником и то же задание, что в её статье.
Чайник на плите закипает и громко свистит, из носика валит пар. Кот на подоконнике вздрагивает от свиста, поворачивает голову к чайнику и недовольно мяукает. За окном шумит дождь, капли барабанят по стеклу. Камера медленно приближается к чайнику.
из одного фото, 540p, 5 с
Ролик пришёл вертикальным, 536×962 точки, как исходник, и снят одним планом: камера плавно наезжает на чайник, а кот к концу поворачивается к плите.
Русская речь из одного фото
Говорят герои и без голосового образца, модель подбирает голос сама. На этой картинке девушка с велосипедом у почтового ящика: за восемь секунд Q4 успела опустить письмо, повернуться к камере с репликой, сесть на велосипед и уехать вглубь улицы.
Девушка опускает письмо в синий почтовый ящик, оборачивается к камере и весело говорит по-русски: «Всё, отправила! Теперь только ждать ответа.» Потом садится на зелёный велосипед и уезжает по осенней улице, листья кружатся. Камера плавно следует за ней.
из одного фото, 540p, 8 с
Все действия на месте и по порядку. С речью хуже: слова смазаны, и распознавание разобрало только «Всё…» и «теперь… ожидает». В другой пробе из одного фото, с новогодним поздравлением, тоже понятна была лишь половина фразы. А в роликах по референсам русские реплики звучали чисто, даже без голосового образца: в пробе с котом, приёмником и героиней в кресле (она во вкладке «Примеры») фразу распознали слово в слово. Проб немного, две из одного фото и три по референсам, но для сцены, где важен текст, мы бы загружали портрет героя и вторую картинку (фон или предмет): так включается режим референсов.
Как это работает: режим выбирают файлы
Переключателя режимов в форме нет, режим определяют файлы. Напишите в поле Задание, что происходит в кадре, кто что говорит и как движется камера. Затем загрузите картинки в поле Изображения.
- Одна картинка и пустое поле Голоса — ролик начнётся с этой картинки и сохранит её пропорции, звук будет всегда.
- Две картинки и больше или хотя бы один голос — видео по референсам. Картинки не становятся кадром: модель строит новую сцену и переносит в неё героев, предметы и места. Появятся поля Соотношение сторон и Со звуком.
Метки @image1, @image2 и @audio1 нумеруются по порядку загрузки. Выберите качество и длительность, и цена появится на кнопке Отправить ещё до запуска. Ролики из одного фото у нас приходили примерно за три минуты, по референсам — от пяти до семнадцати минут. Готовое видео встанет в ленту под формой и пролежит в разделе Мои результаты 7 дней: удачный ролик скачайте или сохраните в библиотеку. Изменить вернёт задание, файлы и настройки в форму, Повторить сразу отправит то же задание ещё раз. Впервые на сайте? Загляните в инструкцию по сайту.
Настройки: качество, длина, формат и звук
| Поле | Что делает | Что ставить |
|---|---|---|
| Качество | разрешение ролика: 540p, 720p, 1080p, 2K или 4K, по умолчанию 720p | 540p для проб задания, 1080p для готового ролика; 2K и 4K — когда видео пойдёт на большой экран или в монтаж с обрезкой |
| Длительность | от 3 до 16 секунд, по умолчанию 5; оплата за каждую секунду | одной сцене хватает 5 секунд, реплике с действием — 8, диалогу двух героев — 10 |
| Соотношение сторон | формат кадра в режиме референсов: 16:9, 9:16, 4:3, 3:4 или 1:1 | 9:16 для сторис и клипов, 1:1 для ленты; с одним фото поля нет, формат берётся у картинки |
| Со звуком | реплики и звуки сцены в режиме референсов, включён сразу | выключайте, если ролик пойдёт под свою музыку или закадровый голос; на цену не влияет |
| Голоса | до 3 файлов MP3 по 3–12 секунд | чистая запись одного человека без музыки; длинный файл обрежьте заранее, иначе запуск может не пройти |
Как писать задание для Q4
Рабочая формула из наших проб: кто в кадре (метка или описание) → что делает по порядку → реплика в кавычках с языком и голосом → звуки → свет и движение камеры. Реплику лучше ставить в кавычки и прямо писать «говорит по-русски», так модель не спутает текст речи с описанием сцены.
@image1 стоит у окна кофейни и держит @image2. Поворачивается к камере и говорит по-русски голосом @audio1: «Попробуйте, это наш новый сорт.» Слышен шум кофемашины и тихий джаз. Тёплый дневной свет, камера медленно приближается.
Девушка на фото оборачивается, смеётся и машет рукой. Ветер шевелит волосы, вдалеке шумит море и кричат чайки. Камера плавно отъезжает назад.
Частые ошибки:
- Слишком много действий на короткий ролик. Модель выберет часть, у нас это была то героиня, которая «уже вошла», то кот без обещанного наклона головы. Прибавьте секунды или уберите лишнее.
- Метка без файла. Если написать
@image3, а картинок две, форма предупредит, но запуск не остановит, и модели придётся угадывать, кто это. - Одна картинка, когда нужна сцена «по мотивам». С одним фото ролик начинается именно с него. Для новой сцены с тем же героем добавьте вторую картинку, например фон.
Сколько стоит ролик
Цена считается за каждую секунду, ставка зависит только от качества. Режим, число картинок и голосов, формат кадра и звук на неё не влияют.
| Качество | Длина | Цена |
|---|---|---|
| 540p | 3 с | 24 ₽ |
| 540p | 5 с | 40 ₽ |
| 720p | 5 с | 80 ₽ |
| 1080p | 8 с | 160 ₽ |
| 1080p | 10 с | 200 ₽ |
| 2K | 5 с | 175 ₽ |
| 4K | 5 с | 300 ₽ |
| 4K | 16 с | 960 ₽ |
Задание и расстановку героев удобно отлаживать в 540p на 3–5 секундах: метки, реплики и смена планов там уже видны. Финальную версию запускайте в нужном качестве. Если ролик не получился из-за ошибки нейросети, деньги вернутся на баланс.
Для чего подойдёт
- Короткая сцена с постоянными героями: один и тот же персонаж и предмет в нескольких роликах по одним референсам.
- Реклама товара: фото продукта плюс портрет ведущего, реплика по-русски в кадре.
- Диалог двух персонажей своими голосами для сторис, скетча или учебного ролика.
- Оживить фото: снег, ветер, улыбка и звуки улицы вокруг одного снимка.
- Вертикальный ролик 9:16 из картинок любой формы: в режиме референсов формат задаёте вы.
- Черновик сцены перед съёмкой: как лягут планы, сколько секунд нужно на реплику.
Ограничения Q4
- Из одного фото русская речь в наших пробах выходила смазанной. Для важного текста включайте режим референсов (две картинки или голос) или озвучьте реплику отдельно в разделе «Озвучка текста».
- Голоса принимаются только в MP3, от 3 до 12 секунд каждый. Длину форма не проверяет: файл короче или длиннее модель может отклонить, тогда деньги вернутся на баланс.
- По референсам ждать дольше: диалог на 10 секунд в 1080p с двумя голосами у нас шёл около 17 минут. Задание удобнее отладить в 540p на коротком ролике.
- Без картинки Q4 не запускается: хотя бы одна нужна всегда. Ролик только по описанию снимает Q3 и другие модели из раздела «Видео из текста».
- Это предварительная версия модели, Q4 Preview: разработчик может её менять.
Q4, Q3 и другие нейросети по референсам
У Vidu Q3 нет режима референсов и голосовых образцов, зато она снимает ролик по одному описанию и умеет задавать конечный кадр. На той же кухне Q3 вставила второй план посередине, а Q4 провела камеру одним движением, и кот у неё всё-таки повернулся к плите. Q3 в пробе из её статьи русскую реплику не выговорила, а Q4 говорит по-русски. Остальные модели ShengShu собраны в обзоре нейросетей Vidu, соседи по задаче — в разделе «Видео по референсам».
| Нейросеть | Цена | Чем отличается | Когда брать |
|---|---|---|---|
| Vidu Q4 | от 8 ₽/сек. | 1–12 картинок и до 3 голосов в MP3, 3–16 с, до 4K, режим по числу файлов | сцена с постоянными героями и репликами своими голосами |
| Vidu Q3 | от 12 ₽/сек. | из текста или одной картинки, есть конечный кадр, 1–16 с, до 1080p, речь без русского | ролик только по описанию или переход к заданному кадру |
| Vidu Q3 Ad | от 22,5 ₽/сек. | реклама по 1–7 картинкам товара, 720p или 1080p | рекламный ролик продукта |
| Wan 3.0 Video | от 5 ₽/сек. | до 10 картинок, 5 видео и 5 аудио в референсах, до 1080p | сцена по образцам с видео-референсами |
| MiniMax H3 | от 6 ₽/сек. | до 9 картинок, 3 видео и 3 аудио в референсах, до 2K, шесть пропорций | нужен формат 21:9 или видео-образец движения |
| Kling 3.0 | от 11 ₽/сек. | до 7 картинок-референсов, 720p–4K, ещё и переделка готового видео | переделать уже снятый ролик |
Частые вопросы
Описание обновлено 8 октября 2026 г.
Девушка с радиоприёмником на ночной неоновой улице
Два референса, 720p, 5 с, 9:16, звук выключен: вертикальный кадр для сторис, героиня и предмет с картинок.
Промпт: Женщина с @image1 в жёлтом дождевике быстро шагает под дождём по мокрой ночной улице с неоновыми вывесками и несёт под мышкой @image2. Она идёт прямо на камеру, камера отъезжает назад перед ней. Отражения огней в лужах, капли летят с капюшона.
Вечер в кресле: кот, книга и старое радио
Три референса без голосов, 540p, 6 с, 1:1: кот, приёмник и героиня в одной сцене, фраза по-русски.
Промпт: Уютная комната вечером. @image3 сидит в кресле с книгой, рядом на тумбочке стоит @image2 и тихо играет старую песню. @image1 запрыгивает к ней на колени и сворачивается клубком. @image3 гладит кота, улыбается и тихо говорит по-русски: «Ну что, рыжий, опять пришёл слушать радио?» Мягкий свет торшера.
Девушка отправляет письмо и уезжает на велосипеде
Одно фото, 540p, 8 с: реплика по-русски и несколько действий подряд в одном ролике.
Промпт: Девушка опускает письмо в синий почтовый ящик, оборачивается к камере и весело говорит по-русски: «Всё, отправила! Теперь только ждать ответа.» Потом садится на зелёный велосипед и уезжает по осенней улице, листья кружатся. Камера плавно следует за ней.
Диалог покупательницы и продавца в антикварной лавке
Три референса и два голоса, 1080p, 10 с: двое героев говорят по-русски, каждый своим голосом.
Промпт: Антикварная лавка. @image1 стоит за прилавком, на прилавке @image3. Входит @image2, видит приёмник и говорит по-русски голосом @audio2: «Ой, какой красивый! Он правда ещё работает?» @image1 улыбается и отвечает голосом @audio1: «Конечно. Сейчас включу.» Он поворачивает ручку, начинает играть музыка. Камера переходит с одного героя на другого.
Мастер в мастерской показывает старый приёмник
Фото героя, фото приёмника и голос в MP3, 720p, 8 с: реплика по-русски голосом из файла.
Промпт: @image1 сидит в маленькой мастерской за верстаком, заваленным лампами и проводами, и бережно протирает @image2. Потом поднимает взгляд в камеру и говорит по-русски голосом @audio1: «Этому приёмнику шестьдесят лет, а поёт как новый.» Тёплый свет настольной лампы, камера медленно приближается.
Свистящий чайник и кот на кухне под дождём
Одно вертикальное фото, 540p, 5 с: только звуки сцены, камера приближается одним планом без склеек.
Промпт: Чайник на плите закипает и громко свистит, из носика валит пар. Кот на подоконнике вздрагивает от свиста, поворачивает голову к чайнику и недовольно мяукает. За окном шумит дождь, капли барабанят по стеклу. Камера медленно приближается к чайнику.
Новогоднее поздравление на заснеженной улице
Одно фото стало первым кадром, 720p, 5 с: героиня говорит по-русски, слышны скрип снега и колокольчики.
Промпт: Идёт снег, женщина моргает, улыбается в камеру и говорит по-русски тёплым голосом: «С наступающим! Пусть в новом году всё сбудется.» Огни витрин мягко мерцают, слышен скрип снега и далёкий звон колокольчиков. Камера медленно приближается.
Кот и ламповый приёмник на столе у окна
Два референса — приёмник и кот, 540p, 5 с, 16:9: метки @image1 и @image2 расставили героев слева и справа, как в задании.
Промпт: На деревянном столе у окна: слева стоит @image1, справа сидит @image2. @image2 медленно тянется лапой к ручке настройки, из динамика начинает тихо играть джаз, @image2 удивлённо наклоняет голову. Тёплый утренний свет, камера неподвижна.