Нейросети Google на сайте делают видео со звуком, озвучку, музыку и примерку одежды по фото. Ролики снимают Veo 3.1 и две версии Gemini Omni, голос дают четыре модели Gemini TTS (3.8 Flash, 3.8 Flash Lite, 3.1 Flash и 2.5 Flash), песни пишут Lyria 3 Pro и Lyria 3.5, а Замена одежды (Google) показывает вещь на человеке. Всё работает из России без VPN: вы платите в рублях за каждый запуск, подписки нет. Картинки Google, то есть Nano Banana, собраны в своём разделе, о них ближе к концу.
Мы дали одно задание двум моделям Veo 3.1 и обеим версиям Omni: пожилой часовщик поднимает голову от работы и говорит по-русски «Опять спешат? Сейчас разберёмся». Условия одинаковые: 8 секунд, 16:9, 720p. Число с буквой p означает разрешение: 720p хватает для телефона, 1080p и 4K нужны для большого экрана.
Кинематографичная сцена, тёплый дневной свет из окна. Маленькая мастерская часовщика, на стенах тикают десятки старых часов. Пожилой мастер с лупой на глазу поднимает голову от раскрытых карманных часов, улыбается в камеру и говорит по-русски спокойным голосом: «Опять спешат? Сейчас разберёмся». Камера медленно приближается к его лицу. Слышно тиканье часов и тихий звон колокольчика у входной двери.
Фразу все четыре произнесли слово в слово: мы проверили звук распознаванием речи, и текст совпал у всех. Разница видна в деталях. Обе Veo оставили лупу на глазу, как просили, а обе Omni сдвинули её на лоб. Колокольчик вспомнили двое: Veo в модели Обычная поставила его на стол, Omni 1.1 повесила над дверью. Картинка у Veo тёплая и золотистая, как в кино, у Omni цвета спокойнее и ближе к жизни. Каждый ролик пришёл меньше чем за две с половиной минуты.
Для сцены с репликой мы бы взяли Veo 3.1 в модели Fast. Лупу она, как просили в промпте (тексте задания, на сайте это поле Задание), оставила на глазу, а стоит заметно дешевле трёх других роликов сравнения. Omni нужна, когда есть свои материалы: несколько картинок или ролик, который надо переделать.
Veo 3.1 Google выпустила в октябре 2025 года. Ролик у неё всегда 8 секунд, звук и речь она добавляет сама. Главное здесь — два поля. В поле Версия сразу стоит 1: там можно снять ролик по тексту, по одной картинке или по референсам, то есть картинкам-образцам, по которым нейросеть держит внешность героя или предмета (до трёх). В версии 3 есть ещё начальный и конечный кадр, между ними Veo снимает переход. Поле Модель задаёт качество: Lite дешевле всех, но в версии 1 берёт только текст; Fast годится для всех режимов; Обычная дороже всех и не работает с референсами. Разрешение до 4K. Стоит Veo 3.1 от 10 ₽ за ролик, точная цена видна на кнопке до запуска.
Gemini Omni Google показала в мае 2026 года, а Gemini Omni 1.1 вышла в конце августа 2026 года. Обе снимают по тексту и по картинкам-референсам, их до 7, а ещё умеют переделать ваш ролик до 30 секунд: из него берётся фрагмент до 10 секунд, и вы описываете, что поменять — погоду, одежду, обстановку. Картинки, ролик и персонажи делят один лимит: всего не больше семи, ролик считается за два. Длина результата 4, 6, 8 или 10 секунд. Со своим видео цена одна за запуск при любой длине фрагмента, дороже только 4K.
В поле Тип генерации кроме видео есть «Персонаж» и «Аудио». В первом из описания и одной картинки создаётся герой, во втором — голос: выбираете готовый из списка и описываете манеру. Каждый получает свой номер (ID), его вставляют в поле Персонажи или ID аудио нового ролика, персонажей в одном ролике может быть до трёх.
Omni 1.1 умеет всё то же и при тех же настройках немного дешевле. Ещё у неё есть разрешение 360p: по словам Google, такой ролик считается быстрее. Как обе версии переделывают готовое видео, мы сравнили в разделе Редактирование видео.
Gemini 3.8 Flash TTS и её облегчённая версия Gemini 3.8 Flash Lite TTS читают текст одним голосом или разыгрывают диалог двух собеседников. Голоса у них те же 30, что у 3.1 и 2.5, о которых ниже. А диалог собирается иначе: у 3.1 и 2.5 его пишут одним текстом «Имя: реплика», а здесь голоса задаются в полях Голос собеседника 1 и Голос собеседника 2, и реплики добавляются по одной в список Реплики. У каждой вы выбираете в поле Кто говорит собеседника, пишете Текст реплики и при желании просите тон в поле Манера реплики, например «удивлённо». Общая Манера речи задаёт настроение всему тексту.
Выбирать язык не нужно: модель определяет его по тексту. За раз обе озвучивают до 5000 символов, в диалоге считается сумма всех реплик. Смех и вздох вставляются прямо в текст тегами, то есть пометками в угловых скобках, которые вслух не читаются: <laugh> и <sigh>. Платите вы только за символы текста, манера речи в цену не входит: Flash стоит 7 ₽ за 1000 символов, а Lite 5 ₽ за 1000 символов.
Gemini 3.8 Flash TTS · диалог, Aoede и Charon · 7 ₽ за 1000 символов
Gemini 3.8 Flash Lite TTS · диалог, Aoede и Charon · 5 ₽ за 1000 символов
Так мы заполнили форму: каждая строка ниже — отдельная реплика, в скобках голос собеседника.
Собеседник 1 (Aoede): Дима, иди сюда! Бабушкины часы снова пошли.
Собеседник 2 (Charon), манера реплики «шёпотом, не веря»: Не может быть. Они же стояли с две тысячи девятого года.
Собеседник 1: Стояли. А сегодня в семь пятнадцать взяли и затикали! <laugh>
Собеседник 2: <sigh> Ну всё. Теперь они будут будить нас каждый час.
Это тот же разговор, что в примере Gemini 3.1 ниже, с теми же голосами и манерой речи «живой бытовой разговор на кухне, без дикторской интонации». Только шёпот здесь задан манерой реплики, а смех и вздох тегами <laugh> и <sigh>. У обеих версий вышло около 20 секунд звука, и распознавание речи показало, что текст прочитан слово в слово, без тегов вслух. 214 символов во Flash стоили 1,50 ₽, в Lite 1,07 ₽. Разницу в подаче лучше послушать самим.
Обе озвучивают текст одним голосом или разговором двух людей: в режиме Диалог каждая реплика начинается с имени и двоеточия, и у каждого собеседника свой голос. Голосов 30, языков в форме 24, русский среди них. В поле Манера речи можно словами попросить тон и темп. Gemini 3.1 Flash TTS вышла в апреле 2026 года. Она понимает теги в квадратных скобках: [whispering] для шёпота, [laughing] для смеха, [sigh] для вздоха. За раз она берёт до 2500 символов. Gemini 2.5 Flash TTS самая дешёвая из четырёх озвучек Gemini и берёт до 4000 символов: подойдёт для длинного текста, если важна цена.
Вера: Дима, иди сюда! Бабушкины часы снова пошли.
Дима: [whispering] Не может быть. Они же стояли с две тысячи девятого года.
Вера: Стояли. А сегодня в семь пятнадцать взяли и затикали! [laughing]
Дима: [sigh] Ну всё. Теперь они будут будить нас каждый час.
Gemini 3.1 Flash TTS · Диалог: Вера (Aoede) и Дима (Charon), русский · 8 ₽ за 1000 символов
В поле Манера речи мы написали «живой бытовой разговор на кухне, без дикторской интонации». Вышла 21 секунда разговора, теги нейросеть вслух не прочитала. Год и время мы нарочно написали словами, чтобы не гадать, как прочитаются цифры. С другими нейросетями озвучки Gemini мы сравнили в разделе Озвучка текста.
Lyria 3 Pro пишет песню с вокалом или инструментал, по словам Google — до трёх минут, с куплетами и припевом. Полей два: Задание и необязательная картинка для настроения. Трек стоит 12 ₽.
Тёплый инди-фолк про старую мастерскую часовщика: акустическая гитара, щётки на барабанах, тиканье часов в ритме, мягкий мужской вокал на русском, запоминающийся припев про время, которое снова пошло
Lyria 3 Pro · только задание, без картинки · 12 ₽
Текста песни мы не давали, и Lyria сочинила его сама: вышла песня на 2 минуты 27 секунд про ключ, пыль и маятник. Строки местами странные, например «маятник застыл у самого рта». Если слова важны, пишите их сами прямо в Задании.
Lyria 3.5 — более новая музыкальная модель Google DeepMind, и форма у неё подробнее. В режиме По описанию вы заполняете только Задание, а слова модель сочиняет сама. В режиме Свой текст песни слова идут в отдельное поле Текст песни, а жанр и голос — в необязательное Стиль и звучание; на короткий текст модель дописывает свои строки. Ещё можно дать Название трека и включить переключатель Задать темп: появится ползунок от 40 до 220 ударов в минуту, и в наших пробах темп отклонялся не больше чем на пять ударов в минуту. Длину выбрать нельзя: все наши треки вышли от двух с половиной до трёх минут, файлом M4A, иногда по два варианта за запуск. Картинку на вход она не принимает. Трек стоит 10 ₽.
Светлая русская поп-песня о летнем утре у моря: акустическая гитара, лёгкие барабаны, мягкий женский вокал на русском языке, запоминающийся припев.
Lyria 3.5 · режим «По описанию», без темпа · 10 ₽
Трек вышел на три минуты, слова модель сочинила сама, и распознавание речи нашло в нём русский текст. Берите Lyria 3.5, когда слова уже готовы (давайте текст целиком) или нужен точный темп. Музыку по картинке из этих двух делает только Lyria 3 Pro, и короткий трек тоже удобнее в ней: если расписать в задании части песни по секундам, она держит длину, так у нас вышел трек на 40 секунд. Другие нейросети для песен собраны в разделе Музыка.
Замена одежды (Google) надевает вещь с фото товара на человека с вашего снимка. Промпта нет, только два поля: Фото человека и Фото одежды. Для примера мы сгенерировали в Nano Banana 2 выдуманную женщину в полный рост и куртку-бомбер на белом фоне.
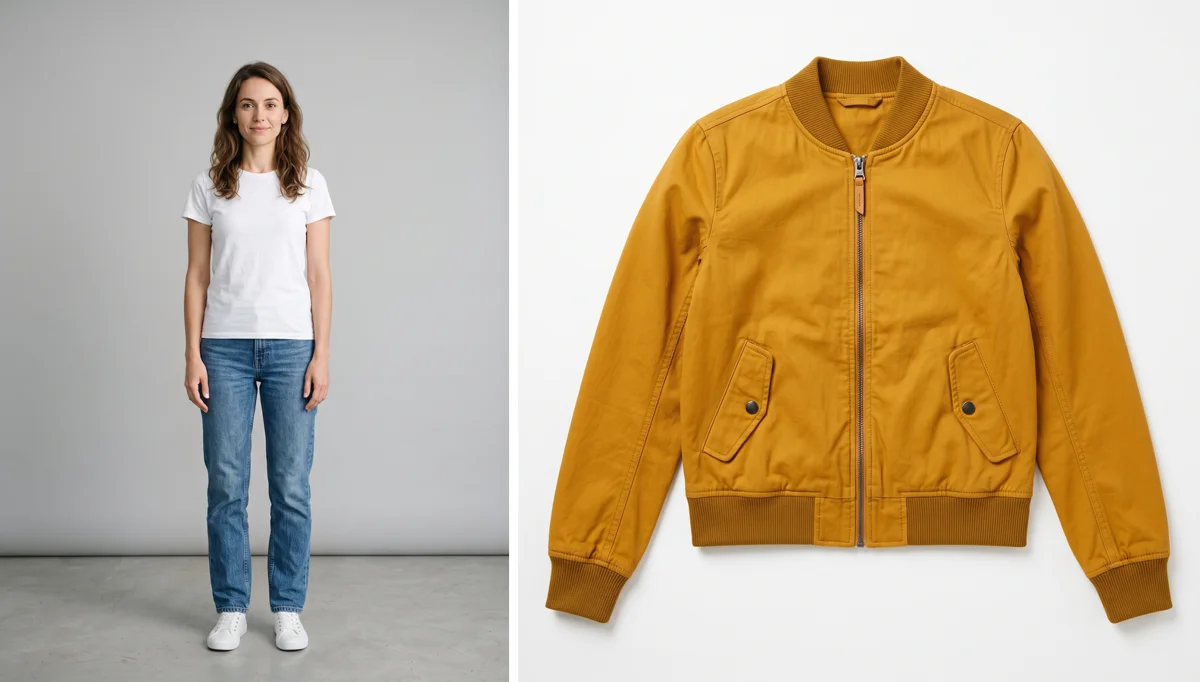
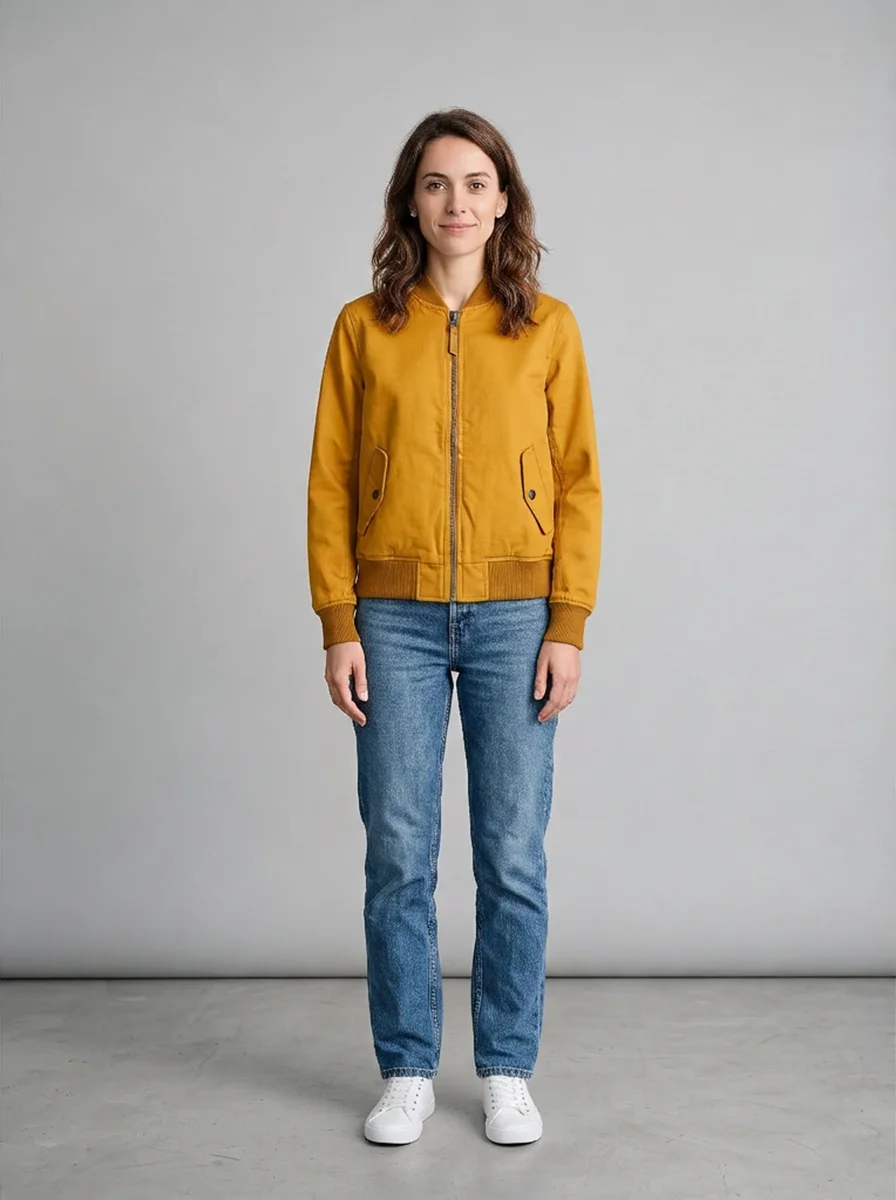
Замена одежды (Google) · фото человека и фото куртки · 12 ₽
Результат пришёл через полминуты. Лицо, поза, джинсы и кеды остались как были, а у куртки сохранились карманы с кнопками, резинки на манжетах и язычок молнии. Google советует брать снимок, где человек виден целиком, при хорошем свете и не в мешковатой одежде, а вещь снимать на ровном фоне. Подробнее об этом написано в инструкции как заменить одежду на фотографии.
Картинки Google на сайте делает семейство Nano Banana из четырёх нейросетей: первая версия, 2, 2 Lite и Pro. Они рисуют по описанию и правят готовые фото, а версию Pro берут на сайте чаще почти всех остальных нейросетей. У семейства свой раздел: нейросети Nano Banana.
В чате есть две модели Gemini. Gemini 3.8 Flash быстро отвечает, понимает картинки и умеет искать в интернете. Gemini 3.1 Flash Lite дешевле и тоже понимает картинки.
| Нейросеть | Цена | Что делает | Чем отличается |
|---|---|---|---|
| Veo 3.1 | от 10 ₽ | Видео 8 с со звуком из текста или картинки | Модели Lite, Fast и Обычная, переход между кадрами |
| Gemini Omni | от 60 ₽ | Видео 4–10 с по тексту, картинкам и своему ролику | Персонажи и голоса, правка своего видео |
| Gemini Omni 1.1 | от 48 ₽ | Видео 4–10 с, те же режимы | Есть 360p, чуть дешевле первой Omni |
| Gemini 3.8 Flash TTS | 7 ₽ за 1000 символов | Озвучка одним голосом или диалогом | Реплики по одной со своей манерой, до 5000 символов |
| Gemini 3.8 Flash Lite TTS | 5 ₽ за 1000 символов | Озвучка одним голосом или диалогом | Те же возможности, что у 3.8 Flash, дешевле |
| Gemini 3.1 Flash TTS | 8 ₽ за 1000 символов | Озвучка одним голосом или диалогом | Тег шёпота, до 2500 символов |
| Gemini 2.5 Flash TTS | 4 ₽ за 1000 символов | Озвучка одним голосом или диалогом | Самая дешёвая, до 4000 символов |
| Lyria 3 Pro | 12 ₽ | Песня или инструментал по описанию | Понимает картинку-референс |
| Lyria 3.5 | 10 ₽ | Песня или инструментал: по описанию или на свои слова | Отдельное поле для слов, темп ползунком |
Если вы только начинаете снимать видео нейросетью, прочитайте инструкцию как создать видео по текстовому описанию. Все примеры для этой статьи обошлись нам примерно в 350 ₽.
Статья обновлена 2 октября 2026 г.
| 12 ₽ |
| Примерка вещи на фото человека |
| Без промпта, два фото |