Нейросети для озвучки текста
Как выбрать
- Gemini 3.8 Flash TTS — Gemini 3.8 Flash TTS — нейросеть Google для озвучки текста: читает до 5000 символов одним из 30 голосов или собирает диалог двух собеседников из отдельных реплик, и у каждой реплики может быть своя манера. Смех и вздох ставятся тегами прямо в тексте, а язык модель определяет сама.
- Стандарт — Стандарт — озвучка текста онлайн шестью русскими голосами: вставьте текст до 4000 символов или загрузите TXT-файл, и через несколько секунд придёт аудиофайл. Паузы, ударения и темп отдельных слов задаются разметкой SSML.
- Gemini 3.8 Flash Lite TTS — Gemini 3.8 Flash Lite TTS — облегчённая модель озвучки от Google: читает текст одним из 30 голосов или разыгрывает диалог двух собеседников. Форма и голоса у неё те же, что у полной версии 3.8, а сама Lite рассчитана на поток однотипной озвучки: объявления, напоминания, уроки.
- Zonos2 — Zonos2 — нейросеть Zyphra, которая читает любой текст голосом из короткой записи: загрузите файл или запишите до 30 секунд своей речи прямо в форме. Удобный способ клонировать голос онлайн без отдельного шага: голос не нужно сохранять заранее, образец идёт в каждый запуск вместе с текстом.
- MiniMax Speech 2.5 — MiniMax Speech 2.5 — нейросеть MiniMax для озвучки текста и клона голоса: 34 готовых голоса, семь эмоций и 40 языков в списке. Тегов смеха и вздохов у этой версии нет, зато она спокойно читает длинный ровный текст: аудиогид, урок, объявление.
- ByteDance Seed Speech TTS 2.0 — ByteDance Seed Speech TTS 2.0 — нейросеть для озвучки текста на английском, китайском и ещё восьми языках, русского у неё нет. Голосов 40, а тон, темп и громкость описывают словами в отдельном поле. Подойдёт для роликов, уроков и презентаций на иностранном языке.
- Qwen3 TTS — Qwen3 TTS — нейросеть Alibaba для озвучки текста на русском и ещё девяти языках. Она читает одним из 9 готовых голосов, собирает новый голос по словесному описанию или повторяет голос по записи на несколько секунд, и всё это в одной форме.
- MiniMax Speech 2.6 — MiniMax Speech 2.6 — нейросеть MiniMax для озвучки текста, которую готовили для голосовых помощников и сообщений с телефонами, почтой и суммами. По-русски в наших пробах верно вышел только телефон в модели HD, остальное надёжнее писать словами. Голоса, эмоции, 40 языков и клон — как у 2.5 и 2.8.
- ByteDance Seed Audio 1.0 — ByteDance Seed Audio 1.0 — нейросеть для озвучки текста на русском. Голос она подбирает сама, повторяет по вашей записи или придумывает по картинке, поэтому с ней удобно сделать голос персонажа: загрузите портрет героя и вставьте его реплику.
- Qwen3 TTS Flash — Qwen3 TTS Flash — нейросеть Alibaba для быстрой озвучки текста готовыми голосами. Выбираете один из 17 голосов, вставляете до 2000 символов на русском, английском или другом языке из списка и получаете запись WAV, без настройки тембра и загрузки образцов.
- Chatterbox TTS — Chatterbox TTS — нейросеть Resemble AI для озвучки английского текста встроенным голосом или голосом с короткой записи, которую можно загрузить или наговорить прямо в форме. Ползунок выразительности делает подачу спокойнее или ярче. Русский текст модель не читает.
Как выбрать нейросеть
Нейросеть для озвучки текста читает написанное вслух выбранным голосом. Так делают закадровый голос для ролика, начитывают урок или сказку на ночь, записывают объявление в магазине. Нейросети в этом разделе заметно разные. Дешёвые ровно читают по-русски длинные тексты, дорогие шепчут и смеются там, где вы попросили, а некоторые умеют разыграть разговор двух людей или повторить голос по короткой записи.
Чтобы разница была слышна сразу, мы дали одну и ту же фразу шести нейросетям, которые советуем пробовать первыми. Дикторы везде женские, настройки по умолчанию.
Один текст в шести нейросетях
В пятницу, 27 сентября, в 19:30 мы открываем новую библиотеку на Садовой. Приходите всей семьёй! Анна Сергеевна, вы ведь тоже придёте? Будет немного тесно… но, честное слово, оно того стоит. А первые 50 гостей получат книгу в подарок.
Мега · голос Марина, эмоция «Нейтральная» · 13 ₽ за 1000 символов
Премиум · голос Алёна, нейтральный · 1 ₽ за 1000 символов
Ультра · голос Дарья · 2 ₽ за 1000 символов
ElevenLabs Eleven v3 · голос Alice, подача «Естественная» · 30 ₽ за 1000 символов
Gemini 3.1 Flash TTS · голос Kore · 8 ₽ за 1000 символов
xAI TTS v1 · голос Eve · 3 ₽ за 1000 символов
Цифры мы оставили цифрами нарочно. Дату с правильным падежом нейросеть должна прочитать сама, и тут выяснилось главное: «двадцать седьмого сентября» сказали Премиум, xAI, ElevenLabs и Gemini, а Ультра и Мега — «двадцать семь сентября». Время «19:30» все прочитали без ошибок. Только Премиум сделал из него книжное «девятнадцать часов тридцать минут», остальные сказали «девятнадцать тридцать», как в разговоре.
Длина записей разная: у ElevenLabs и xAI фраза заняла около 18 секунд, у Меги 22. Зато на многоточии Мега и Ультра молчат почти секунду, и «…но, честное слово» звучит как задумчивая оговорка.
У Ультры самая ровная интонация, голос почти не поднимается и не опускается. Для инструкции это плюс, для рекламы минус. ElevenLabs и xAI читают бодрее и с короткими паузами, но ElevenLabs стоит намного дороже.
Как озвучить текст на сайте
Откройте нейросеть по ссылке или карточке выше, выберите голос (у большинства рядом с именем есть кнопка воспроизведения образца), вставьте текст и нажмите Отправить. Подписки нет. Почти везде платите за символы текста, у некоторых нейросетей — за каждую начатую тысячу символов или за запуск целиком, клон голоса оплачивается отдельно. Итоговая сумма в любом случае видна на кнопке до запуска.
Фразу на 200–300 символов нейросети из нашего сравнения озвучили за 10–25 секунд ожидания, голос по описанию готовился около минуты. Файл появится под формой и в разделе Мои результаты, где его можно прослушать и скачать. Результаты хранятся 7 дней, нужную озвучку лучше сразу сохранить у себя. Если сайт для вас новый, загляните в инструкцию по сайту: там про баланс, историю и настройки.
С каких нейросетей начать
Мега: эмоции, детские голоса и клон
С Меги на сайте начинают чаще всего. У неё отдельные списки взрослых и детских голосов, эмоции от радости до страха, ползунки скорости, громкости и высоты. Текст можно вставить до 10 000 символов или загрузить TXT-файлом до 100 000. Паузу нужной длины ставят прямо в тексте: <#1.5#> даёт полторы секунды тишины.
Одну новость мы озвучили с двумя эмоциями. Грустная версия вышла на полсекунды длиннее: нейросеть сама замедлила речь и говорит ниже, а в радостной голос чаще взлетает вверх.
Эмоция «Радость»
Эмоция «Грусть»
Мы получили ответ из издательства. Нашу книгу напечатают тиражом в три тысячи экземпляров.
Мега · голос Иван, эмоции «Радость» и «Грусть» · 13 ₽ за 1000 символов
Детские голоса нужны для сказок и роликов «от лица малыша»:
Всем привет, это подкаст «Мне полтора». Сегодня обсуждаем важное: почему кашу дают, а печенье нет.
Мега · раздел «Детские», голос Саша · 13 ₽ за 1000 символов
Ещё Мега клонирует голос по записи от 10 до 300 секунд. Клон оплачивается один раз, попадает в «Мои голоса» и дальше работает в Меге. Сама озвучка в Меге стоит 13 ₽ за 1000 символов.
Премиум: недорогой диктор с настроением
Премиум берут ради чистой русской речи без переплаты: 1 ₽ за 1000 символов. Сначала задаёте характер голоса (нейтральный, радостный или дружелюбный), потом диктора: Алёну, Ивана, Захара, Машу и других. Скорость и высоту подправляют ползунками. Текст до 10 000 символов, TXT-файлом до 100 000.
Ультра: 72 голоса, длинные тексты и клон
Ультра даёт 72 готовых голоса на русском, английском, французском и немецком и принимает TXT-файл до 100 000 символов. Спокойная ровная подача подходит курсам, инструкциям и аудиоверсиям статей. Даты с падежом ей лучше писать словами.
Ещё Ультра клонирует голос: в поле Режим выберите Клонировать голос и загрузите запись на 10–30 секунд. Клон сохранится в «Моих голосах», и дальше им можно начитывать длинные тексты, в том числе TXT-файлом.
ElevenLabs Eleven v3: самая живая подача
ElevenLabs Eleven v3 понимает теги в квадратных скобках прямо в тексте: [whispers] (шёпот), [laughs] (смех), [sighs] (вздох), [gasps] (испуганный вдох), [nervous] (волнение). Теги пишутся по-английски, даже если текст русский. Вслух они не звучат, это слышно в примере ниже. Разработчики заявляют больше 70 языков. В поле Подача три режима; для текста с тегами мы взяли Творческую, в ней эмоции ярче.
[whispers] Тише… Слышишь? Кто-то ходит на кухне. [nervous] Я сейчас включу свет. [gasps] Ой! [laughs] Да это же Барсик! Опять пытался открыть холодильник. [sighs] Всё, завтра покупаю замок на дверцу.
ElevenLabs Eleven v3 · голос Alice, подача «Творческая» · 30 ₽ за 1000 символов
Так же дорого стоит только Gemini 3.1, у обеих цена 30 ₽ за 1000 символов. Поэтому ElevenLabs оставляют для текстов, где интонация решает: реклама, страшилка, реплика персонажа. За один запуск можно отправить до 5000 символов, длинный текст придётся делить.
Gemini 3.1 и 2.5 Flash TTS: диалог двух голосов
Разговор двух людей в одном файле делают только две версии Gemini. В поле Тип генерации выберите Диалог, задайте имена собеседников и каждому одного из 30 дикторов, а реплики в тексте начинайте с имени и двоеточия. Имена вслух не читаются. В поле Манера речи тон сцены описывают обычными словами. Сценка ниже сделана в 2.5, ждали её 26 секунд.
Анна: Олег, ты опять купил три книги? Мы же договаривались: одна в месяц!
Олег: Это не три. Это одна книга… в трёх томах.
Анна: Очень смешно. И куда мы их поставим? Полка уже гнётся.
Олег: Я всё продумал. Под кровать! Там ещё полно места.
Анна: Под кровать… Ладно. Но четвёртый том выбираю я.
Олег: Договорились. Кстати, он выходит в пятницу.
Манера речи: живой бытовой разговор, Анна притворно сердится, Олег оправдывается с улыбкой.
Gemini 2.5 Flash TTS · «Диалог»: Анна (Kore) и Олег (Puck), язык Русский · 4 ₽ за 1000 символов
Gemini 3.1 Flash TTS новее и принимает до 2500 символов за раз, её мы и взяли в сравнение. Gemini 2.5 Flash TTS принимает до 4000 символов и стоит заметно дешевле 3.1, так что длинные сценки и пробы удобнее делать в ней.
xAI TTS v1: теги за небольшие деньги
xAI TTS v1 стоит 3 ₽ за 1000 символов и понимает почти те же приёмы, что ElevenLabs. Звуки ставятся тегами в квадратных скобках: [pause] (пауза), [laugh] (смех), [sigh] (вздох). Манеру для куска текста задают парными тегами: <whisper>…</whisper> читается шёпотом, <emphasis>…</emphasis> с нажимом. Теги английские и входят в число символов, а за раз можно озвучить до 15 000 символов.
Знаете, каким был мой первый торт? [pause] Он провалился. Прямо в середину. [laugh] Но я всё равно подала его гостям. <whisper>И никто ничего не заметил.</whisper> С тех пор я точно знаю: <emphasis>крем спасает всё</emphasis>.
xAI TTS v1 · голос Eve, язык Русский · 3 ₽ за 1000 символов
После вопроса [pause] дал секундную паузу, сами теги не прозвучали.
Остальные нейросети
Ту же фразу про библиотеку мы дали ещё четырём нейросетям.
Стандарт · голос Наталья, WAV · 0.5 ₽ за 1000 символов
MiniMax Speech 2.8 · режим HD · от 10 ₽ за 1000 символов
Inworld Realtime TTS 2 · голос Светлана · 10 ₽ за 1000 символов
Qwen3 TTS Flash · голос Katerina, язык Русский · 10 ₽ за 1000 символов
Стандарт прочитал дату правильно, а время, как и Премиум, «девятнадцать часов тридцать минут». Паузы между фразами у него одинаковые, около 0,6 секунды, поэтому чтение сильнее напоминает диктора. Inworld Realtime TTS 2 справилась и с датой, и со временем, а запись у неё самая короткая, 17 секунд. MiniMax Speech 2.8 тоже сказала «двадцать семь сентября». Qwen3 TTS Flash выдала «двадцать семь и сентября».
Дёшево и по-русски
Стандарт самый дешёвый: шесть русских голосов, выбор формата (WAV — для монтажа, OPUS — лёгкий файл для мессенджеров, PCM — «сырой» звук для программ) и SSML — разметка, в которой паузы и ударения задают служебными тегами. Текстом до 4000 символов, TXT-файлом до миллиона, тогда результат приходит в OPUS. Годится для черновиков и длинных докладов.
Эмоции и клон: MiniMax Speech 2.8, 2.6 и 2.5
Три версии MiniMax Speech устроены одинаково: взрослые и детские голоса, эмоции, больше 40 языков, до 10 000 символов и режимы HD (естественнее) и Turbo (быстрее и дешевле). MiniMax Speech 2.8 самая новая и понимает теги звуков в тексте: (laughs), (sighs), (breath), (coughs). MiniMax Speech 2.6, по словам разработчиков, сама правильно читает телефоны, адреса и суммы. У MiniMax Speech 2.5 самый дешёвый режим Turbo. Клон голоса можно сделать в любой из трёх, он общий с Мегой.
Подача словами и иностранные языки
Inworld Realtime TTS 2 читает на 15 языках, включая русский. Подачу пишут в начале текста в квадратных скобках, например [говори медленно и тепло], и эта подсказка не звучит. У Inworld TTS 1.5 те же языки и две модели, Max и более дешёвая Mini. Qwen3 TTS Flash читает одним из 17 голосов; если в тексте смешаны языки, выберите язык «Авто», и она определит его сама. ByteDance Seed Speech TTS 2.0 русского не знает, зато у неё 40 голосов на английском, китайском, японском, испанском и ещё шести языках.
Qwen3 TTS Flash, Qwen3 TTS и Seed Speech TTS 2.0 берут плату за каждую начатую тысячу символов. Наша фраза примерно на 240 символов стоила в Qwen3 TTS Flash как полная тысяча. Отдавайте им текст целиком, по одной фразе выходит дорого. У Zonos2 цена одна за запуск, но текста в запуск помещается не больше 700 символов, около минуты речи.
Особый голос: по описанию, по записи, по картинке
Qwen3 TTS умеет три вещи: читает готовым голосом, повторяет голос по записи на 5–15 секунд и создаёт голос по словесному описанию. С описанием у нас вышла осечка. На русское «пожилой мужчина-сказочник, низкий тёплый голос» нейросеть ответила высоким голосом, совсем не стариковским. То же описание по-английски дало низкий неторопливый голос.
Описание по-русски
Пожилой мужчина-сказочник, низкий тёплый голос с лёгкой хрипотцой, говорит неторопливо и ласково, как дедушка перед сном.
Описание по-английски
Elderly male storyteller, deep warm voice with a slight rasp, speaks slowly and gently, like a grandfather telling a bedtime story.
Текст в обоих случаях один: «Давным-давно, когда реки были шире, а леса гуще, жил на краю деревни старый мельник. Каждый вечер он садился у окна и рассказывал внукам, как однажды поймал в сети говорящую щуку».
Qwen3 TTS · «Описание голоса», язык Русский · 10 ₽ за 1000 символов
Zonos2 повторяет голос по записи до 30 секунд, которую загружают в каждый запуск. Образцом мы взяли 16 секунд мужской речи, созданной другой нейросетью. Новый текст Zonos2 прочитала этим голосом, ждали 18 секунд. Послушайте образец и результат подряд. Текста за раз Zonos2 берёт до 700 символов, это около минуты речи.
Образец голоса
Новый текст этим голосом
Добрый вечер! Сегодня мы пойдём по Невскому от Адмиралтейства к Аничкову мосту. Идти около часа, так что берите удобную обувь и зонт: погода в Петербурге меняется за пять минут.
Zonos2 · образец голоса 16 секунд, настройки по умолчанию · 3 ₽
ByteDance Seed Audio 1.0 читает текст обычным голосом, повторяет голос по одному–трём образцам или подбирает звучание по картинке. Платите за запуск целиком, поэтому выгоднее длинные реплики, до 2000 символов. Вот голос, который она подобрала к портрету капитана (портрет тоже создан нейросетью):
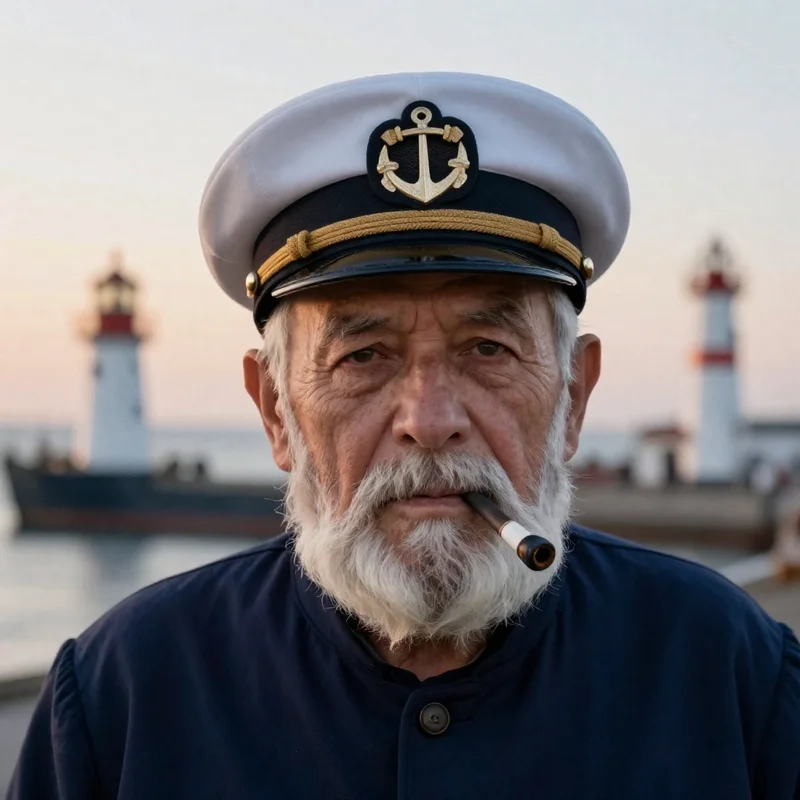
Слушай, юнга. Море не прощает спешки. Сорок лет я водил корабли через шторма и туманы, и вот что я понял: главное — вовремя увидеть свет родного маяка.
ByteDance Seed Audio 1.0 · режим «По изображению» · 50 ₽
Chatterbox TTS озвучивает только английский текст, встроенным голосом или по образцу на 5–30 секунд. Теги звуков она не понимает: <laugh> и <sigh> в нашей пробе прозвучали словами.
Цены, языки и лимиты рядом
Цены в таблице берутся с сайта и всегда актуальны. «За раз» — сколько символов можно отправить в одном запуске.
| Нейросеть | Цена | Русский | За раз | Чем выделяется |
|---|---|---|---|---|
| Мега | 13 ₽ за 1000 символов | да | 10 000, TXT до 100 000 | Эмоции, детские голоса, клон |
| Премиум | 1 ₽ за 1000 символов | да | 10 000, TXT до 100 000 | Характер голоса |
| Ультра | 2 ₽ за 1000 символов | да | 10 000, TXT до 100 000 | 72 голоса, клон по записи |
| ElevenLabs Eleven v3 | 30 ₽ за 1000 символов | да | 5000 | Самая живая подача |
| Gemini 3.1 Flash TTS | 8 ₽ за 1000 символов | да | 2500 | Диалог двух голосов |
| xAI TTS v1 | 3 ₽ за 1000 символов | да | 15 000 | Смех, паузы и шёпот тегами |
| Стандарт | 0.5 ₽ за 1000 символов | да | 4000, TXT до 1 млн | Самая дешёвая, SSML |
| Zonos2 | 3 ₽ | да | 700 | Голос по записи до 30 с |
| Gemini 2.5 Flash TTS | 4 ₽ за 1000 символов | да | 4000 | Недорогой диалог двух голосов |
| Chatterbox TTS | 5 ₽ за 1000 символов | нет | 5000 | Английский, голос по образцу |
| Inworld TTS 1.5 | от 6 ₽ за 1000 символов | да | 2000 | Модели Max и Mini |
| MiniMax Speech 2.5 | от 8 ₽ за 1000 символов | да | 10 000 | Эмоции и клон, дешёвый Turbo |
| MiniMax Speech 2.6 | от 10 ₽ за 1000 символов | да | 10 000 | Телефоны и суммы читает сама (по словам разработчиков) |
| MiniMax Speech 2.8 | от 10 ₽ за 1000 символов | да | 10 000 | Смех и вздохи в тексте |
| Inworld Realtime TTS 2 | 10 ₽ за 1000 символов | да | 2000 | Подача словами в скобках |
| Qwen3 TTS | 10 ₽ за 1000 символов | да | 5000 | Голос по описанию и клон |
| Qwen3 TTS Flash | 10 ₽ за 1000 символов | да | 2000 | 17 голосов, автоязык |
| ByteDance Seed Speech TTS 2.0 | 10 ₽ за 1000 символов | нет | 5000 | 10 иностранных языков |
| ByteDance Seed Audio 1.0 | 50 ₽ | да | 2000 | Голос по картинке |
Что выбрать под задачу
Длинный доклад, курс или статью дешевле всего озвучить в Стандарте или Премиуме, файлом TXT. В Ультре чуть дороже, зато 72 голоса и клон своего голоса. Рекламе, истории или ролику в соцсети нужна интонация, и тут мы бы начали с xAI TTS v1: теги у неё похожи на теги ElevenLabs Eleven v3, а стоит она намного дешевле. ElevenLabs берите, когда нужна ещё более яркая игра.
Сказку или мультик удобно собирать в Меге, где есть детские голоса и эмоции. Для рассказчика с особым тембром опишите голос в Qwen3 TTS, лучше по-английски.
Свой голос на один раз проще взять в Zonos2 или Qwen3 TTS: образец загружается прямо в запуск. Если голос нужен надолго, клонируйте его один раз: в Ультре по записи на 10–30 секунд, чтобы недорого начитывать длинные тексты, или в Меге по записи до 300 секунд, если нужны эмоции. Клон остаётся в «Моих голосах», а созданный в Меге работает и в MiniMax Speech.
Разговор двух людей делают только в Gemini. Для проб и длинных сценок берите 2.5, она дешевле и принимает больше текста.
Для иностранных языков выбор широкий: ElevenLabs, MiniMax Speech и Inworld читают и по-русски, и на многих других языках, так что один голос может звучать в обеих версиях ролика. Seed Speech TTS 2.0 русского не знает, но даёт отдельных дикторов для английского, китайского и японского. Английский с голосом по образцу делает Chatterbox TTS.
Если озвучку потом должен произнести человек на фото или в видео, загляните в раздел Липсинк, а музыку под закадровый голос делают в разделе Музыка. В блоге есть пошаговые инструкции: как озвучить текст и как клонировать голос.
Как подготовить текст, чтобы его прочитали без ошибок
- Даты и числа с падежом пишите словами. С «27 сентября» четыре нейросети из десяти в нашем сравнении ошиблись в падеже. Словами «двадцать седьмого» ошибиться негде.
- Раскрывайте сокращения и знаки: «рублей» вместо «₽», «минут» вместо «мин».
- Паузы ставьте явно: в Меге —
<#1.5#>, в xAI —[pause]и[long-pause], в Стандарте — SSML. Многоточие тоже даёт паузу, но разной длины: у Меги и Ультры почти секунда, у остальных заметно короче. - Если нейросеть не поняла описание голоса или манеры, перепишите его по-английски. Qwen3 TTS после этого дала низкий неторопливый голос, как мы и просили.
- Прежде чем озвучивать весь текст, прогоните один абзац через две-три нейросети. Наш прогон одной фразы через десять нейросетей обошёлся примерно в 35 ₽.
- Для клона голоса берите чистую запись одного человека без музыки, шума и эха. Об этом просят все нейросети с клоном на сайте, и у Zonos2 нам хватило 16 секунд такой записи.
Вопросы про озвучку
Статья обновлена 3 октября 2026 г.