Нейросети для работы со звуком
Как выбрать
- Mirelo SFX 2.0 — Mirelo SFX 2.0 — нейросеть немецкой компании Mirelo, которая озвучивает видео: смотрит, что происходит в кадре, убирает случайную музыку, оставляет речь героев и собирает вокруг неё шаги, двери, воду и фон. Берёт ролики до 10 минут, умеет отдать только дорожку и делает эффекты по описанию.
- ElevenLabs Sound Effect V2 — ElevenLabs Sound Effect V2 — нейросеть для звуковых эффектов: по короткому описанию на английском делает шаги, удары, «вжухи» и фоновые шумы длиной от полсекунды до 22 секунд. Её берут, когда звук нужен точно под длину кадра, а фон должен крутиться петлёй без щелчка на стыке.
- MiniMax Speech 2.8 — MiniMax Speech 2.8 — нейросеть MiniMax для озвучки текста взрослыми и детскими голосами, с выбором эмоции и клоном своего голоса. Смех, вздох и паузу можно вписать прямо в текст, а модель HD или более быструю Turbo выбирают под задачу.
- YuE2 3B — YuE2 3B — открытая музыкальная нейросеть, которая поёт ваш текст в стиле, описанном словами, и умеет перепеть готовую песню по её мелодии: с новым текстом или в другом жанре. Русский текст в наших пробах спет разборчиво.
- Lyria 3.5 — Lyria 3.5 — нейросеть Google DeepMind для музыки: пишет песню с вокалом или инструментал около трёх минут по описанию либо поёт ваш текст в выбранном стиле, в том числе по-русски. Темп задаётся числом, текст и стиль — в разных полях.
- Разделить на дорожки — Разделить на дорожки — нейросеть, которая отделяет голос от музыки: из одной песни делает вокал и минус, а музыку раскладывает ещё и на барабаны, бас и остальное. Заодно она размечает куплеты и припевы и отмечает щелчками каждую долю. Настраивать ничего не нужно, достаточно загрузить файл.
- Gemini 3.8 Flash Lite TTS — Gemini 3.8 Flash Lite TTS — облегчённая модель озвучки от Google: читает текст одним из 30 голосов или разыгрывает диалог двух собеседников. Форма и голоса у неё те же, что у полной версии 3.8, а сама Lite рассчитана на поток однотипной озвучки: объявления, напоминания, уроки.
- ElevenLabs Eleven v4 Turbo — ElevenLabs Eleven v4 Turbo — быстрая версия модели озвучки Eleven v4. Поля и теги у неё те же: 22 голоса, выбор языка, эмоции и звуки в квадратных скобках. ElevenLabs делала её для голосовых ассистентов, а на сайте она подойдёт для уведомлений, аудиогидов и уроков.
- MiniMax Speech 2.5 — MiniMax Speech 2.5 — нейросеть MiniMax для озвучки текста и клона голоса: 34 готовых голоса, семь эмоций и 40 языков в списке. Тегов смеха и вздохов у этой версии нет, зато она спокойно читает длинный ровный текст: аудиогид, урок, объявление.
- Treblo — Treblo (Требло) — музыкальная нейросеть, которая пишет песни по описанию или вашим стихам, делает каверы и поёт новые песни голосом или в стиле загруженного трека. Ещё она продлевает готовый трек и заменяет в нём одну строчку, не трогая остальное.
- ElevenLabs Sound Effect V3 — ElevenLabs Sound Effect V3 (SFX v3) — нейросеть ElevenLabs, которая по текстовому описанию делает звуковые эффекты: шаги, удары, сигналы для игр и фоны до 30 секунд, в том числе петлёй. От V2 отличается более длинным файлом, а в нашей пробе поняла и описание на русском.
- Mirelo AI SFX 1.6 — Mirelo AI SFX 1.6 — нейросеть немецкой компании Mirelo для звуковых эффектов: озвучивает ролик длиной до минуты, делает звук по описанию и зацикленный фон без заметного шва. Выручает и тогда, когда готовую запись надо удлинить или заменить в ней неудачный кусок, не переделывая её целиком.
- Mureka AI V9.5 — Mureka V9.5 — новая версия музыкальной нейросети Skywork AI: поёт ваш текст по-русски в заданном стиле и пишет фоновую музыку без слов. Текст песни помещается до 5000 знаков, а голос можно выбрать: женский, мужской или на усмотрение модели.
- Lyria 3 Pro — Lyria 3 Pro — нейросеть Google DeepMind, которая пишет музыку по описанию: песню на ваши стихи или с текстом, который сочинит сама, инструментал, фон для ролика и даже трек по картинке. Ход трека можно расписать по секундам, а поёт она и по-русски.
- xAI TTS v1 — xAI TTS v1 — озвучка Grok: нейросеть xAI, создателей чат-бота Grok, читает текст одним из 28 голосов, а шёпот, смех, вздох, паузу и даже пение задают короткие теги прямо в тексте. Русский и ещё 15 языков, до 15 000 символов за раз — хватит и на объявление, и на главу рассказа.
- Zonos2 — Zonos2 — нейросеть Zyphra, которая читает любой текст голосом из короткой записи: загрузите файл или запишите до 30 секунд своей речи прямо в форме. Удобный способ клонировать голос онлайн без отдельного шага: голос не нужно сохранять заранее, образец идёт в каждый запуск вместе с текстом.
- MiniMax Speech 2.6 — MiniMax Speech 2.6 — нейросеть MiniMax для озвучки текста, которую готовили для голосовых помощников и сообщений с телефонами, почтой и суммами. По-русски в наших пробах верно вышел только телефон в модели HD, остальное надёжнее писать словами. Голоса, эмоции, 40 языков и клон — как у 2.5 и 2.8.
- VEED Clean Audio — VEED Clean Audio — нейросеть, которая убирает шум из записи речи: улицу, кафе, ветер, гул кондиционера. Заодно выравнивает громкость голоса. Подходит, чтобы улучшить запись голоса из интервью, голосового или ролика: файл можно загрузить как аудио, так и видео.
- Qwen3 TTS — Qwen3 TTS — нейросеть Alibaba для озвучки текста на русском и ещё девяти языках. Она читает одним из 9 готовых голосов, собирает новый голос по словесному описанию или повторяет голос по записи на несколько секунд, и всё это в одной форме.
- ElevenLabs Audio Isolation — ElevenLabs Audio Isolation — нейросеть, которая помогает убрать шум из видео или аудиозаписи и оставить только голос: без гула, машин за окном, музыки и чужих разговоров. Пригодится, когда голосовое записано на улице, интервью в кафе, а ролик снят на телефон.
- Gemini 2.5 Flash TTS — Gemini 2.5 Flash TTS — нейросеть Google для озвучки текста: читает его одним из 30 голосов или разыгрывает диалог двух собеседников. За один запуск берёт до 4000 знаков, около пяти с половиной минут речи, а язык произношения выбирают из 24 вариантов.
- Ультра — Ультра — нейросеть для озвучки текста на русском, английском, французском и немецком: 72 готовых диктора, текст до 10 000 символов в форме или TXT-файл до 100 000. Подойдёт для курсов, инструкций и роликов, которые нужны сразу на нескольких языках.
- MiniMax Music 3.0 — MiniMax Music 3.0 — нейросеть китайской компании MiniMax, которая поёт ваш текст песни с аранжировкой. Звучание описывают в одном поле, слова в другом, а пометки в квадратных скобках задают куплеты, припевы и проигрыши.
- Стандарт — Стандарт — озвучка текста онлайн шестью русскими голосами: вставьте текст до 4000 символов или загрузите TXT-файл, и через несколько секунд придёт аудиофайл. Паузы, ударения и темп отдельных слов задаются разметкой SSML.
- Kling Video-to-Audio — Kling Video-to-Audio — нейросеть Kuaishou, которая смотрит на ролик до 20 секунд и сочиняет к нему звук: рёв мотора, плеск, шорох бумаги, грохот. Выручает, когда нужно наложить звук на видео нейросетью: ролик немой или родная дорожка не нравится. Для мелких звуков есть ASMR‑режим.
- Анализ аудио — «Анализ аудио» слушает загруженную запись и отвечает текстом на ваш вопрос о ней: о чём договорились на созвоне, что дословно сказано, какой жанр и темп у песни, какие звуки слышны. Такой анализ аудиозаписи удобен, когда нужна не вся расшифровка, а один ответ.
- Sonilo 1.0 — Sonilo 1.0 — первая версия нейросети, которая пишет музыку без слов и звуковые эффекты по описанию или под загруженный ролик. Годится для фона к видео, подкасту и презентации, а музыку присылает сразу в MP3.
- MMaudio v2 — MMaudio v2 — нейросеть, которая делает звук к готовому ролику: смотрит на кадры, читает короткое описание и добавляет шаги, удары, плеск и фон в те моменты, когда они случаются на экране. Выручает, если видео снято без микрофона или сделано в видеонейросети без звука.
- ByteDance Seed Audio 1.0 — ByteDance Seed Audio 1.0 — нейросеть для озвучки текста на русском. Голос она подбирает сама, повторяет по вашей записи или придумывает по картинке, поэтому с ней удобно сделать голос персонажа: загрузите портрет героя и вставьте его реплику.
- DeepFilterNet3 — DeepFilterNet3 — открытая нейросеть для шумоподавления речи: приглушает гул вентилятора, шипение диктофона и шум улицы, а голос оставляет. Подойдёт, чтобы очистить голос от шума в голосовом, лекции или подкасте длиной до 10 минут. Готовый файл можно взять в WAV для монтажа или в сжатом формате.
- Inworld TTS 1.5 — Inworld TTS 1.5 — нейросеть Inworld AI для озвучки текста готовыми голосами на 15 языках, в том числе на русском. На выбор две модели, Max и более дешёвая Mini, а темп и выразительность голоса подстраивают ползунками.
- Аудио-конвертер — Аудио-конвертер пересохраняет запись в другом формате: на входе MP3, WAV, M4A, AAC, FLAC, OGG, Opus или WMA, на выходе MP3, WAV, AAC, FLAC, OGG, M4A или WMA. Пригодится, когда сайт не принимает тяжёлый WAV, диктофон iPhone записал M4A, а монтажной программе нужен WAV.
- Inworld Realtime TTS 2 — Inworld Realtime TTS 2 — нейросеть Inworld AI для озвучки текста на 15 языках, включая русский. Интонацию ей задают словами в квадратных скобках прямо в тексте: можно попросить шёпот, грусть или бодрый темп, сменить настроение посреди записи, а сама подсказка вслух не звучит.
- Kling Voice — Kling Voice — нейросеть Kuaishou, которая по записи речи на 5–30 секунд создаёт голос для героев видео Kling 3.0 и выдаёт его номер. Сама она ничего не озвучивает: номер вставляют в форму Kling 3.0, чтобы персонаж ролика заговорил этим тембром.
- ElevenLabs Music v2.5 — ElevenLabs Music v2.5 — новая версия Eleven Music, музыкальной нейросети ElevenLabs: песни с вокалом и музыка без слов по текстовому описанию. Длину трека вы задаёте сами, от 3 секунд до 10 минут, а слова песни, в том числе русские, вписываете прямо в задание.
- HunyuanVideo-Foley — HunyuanVideo-Foley — нейросеть Tencent, которая озвучивает немое видео: смотрит, что происходит в кадре, и добавляет фоли звуки — шум волн, шаги, скрип, треск пластинки. Задание можно не писать, а если написать, она добавит и звук, которого в кадре нет.
- Mirelo SFX V1.5 — Mirelo SFX V1.5 — нейросеть немецкой компании Mirelo, которая делает короткие звуки для видео: смотрит ролик до 10 секунд и подкладывает под него удары, грохот, мотор или шаги. За один запуск она присылает два разных варианта дорожки, и лучший можно выбрать на слух.
- Qwen3 TTS Flash — Qwen3 TTS Flash — нейросеть Alibaba для быстрой озвучки текста готовыми голосами. Выбираете один из 17 голосов, вставляете до 2000 символов на русском, английском или другом языке из списка и получаете запись WAV, без настройки тембра и загрузки образцов.
- ElevenLabs Music v2 — ElevenLabs Music v2 — прошлая версия музыкальной нейросети ElevenLabs: пишет песни с вокалом и музыку без слов по текстовому заданию, русский текст тоже поёт. Пригодится, чтобы продолжить серию треков в том же звучании или услышать другую аранжировку задания, уже сделанного в v2.5.
- ByteDance Seed Speech TTS 2.0 — ByteDance Seed Speech TTS 2.0 — нейросеть для озвучки текста на английском, китайском и ещё восьми языках, русского у неё нет. Голосов 40, а тон, темп и громкость описывают словами в отдельном поле. Подойдёт для роликов, уроков и презентаций на иностранном языке.
- Chatterbox TTS — Chatterbox TTS — нейросеть Resemble AI для озвучки английского текста встроенным голосом или голосом с короткой записи, которую можно загрузить или наговорить прямо в форме. Ползунок выразительности делает подачу спокойнее или ярче. Русский текст модель не читает.
Как выбрать нейросеть
Нейросети для работы со звуком на нашем сайте читают текст голосом, сочиняют песни и фоновую музыку, делают шумы и звук к немому ролику, чистят запись от гула, переводят речь в текст и разбирают готовый трек на дорожки. В разделе 52 нейросети, среди них инструменты для готовых записей. Сначала покажем одно поздравление, сделанное голосом и песней, потом пройдём по задачам, а в конце разберём, как сделать свой голос.
Одно поздравление: прочитать или спеть
Мы написали шесть строк поздравления и отдали их трём нейросетям раздела. Мега их читает, Suno и Mureka AI V9 поют. Текст у всех один, стиль для песен тоже: «весёлый поп, мужской вокал, акустическая гитара, хлопки, праздничное настроение».
С днём рожденья, Серёжа, друг,
Самый лучший из всех вокруг!
Пусть в работе растёт успех,
А за ужином — громкий смех.
Тридцать лет — всё ещё впереди,
Пой, танцуй и гостей зови!
Мега · голос Марина, эмоция «Радость» · 13 ₽ за 1000 символов
Suno · V6, режим «Продвинутый», 60 с · 10 ₽ за 2 трека
Mureka AI V9 · «Создать песню», длина не задаётся · от 7 ₽
Мега ответила через 10 секунд и прочитала текст как стихи: 15 секунд звучания, после каждой строки пауза около полусекунды. Из трёх это самый быстрый и дешёвый вариант. Suno думала 47 секунд и выдала сразу два трека, оба по минуте: в режиме Продвинутый мы поставили Длительность 60 секунд. Поля длины у Mureka нет: через минуту пришла песня на 2,5 минуты, в которой текст звучит дважды, с проигрышем посередине.
Голосовое сообщение спокойно отдавайте Меге. Песню, которую включат за столом, берите в Suno: из двух вариантов проще выбрать, а длину можно задать, хотя попадает в неё Suno не всегда. Чем ещё различаются музыкальные нейросети, мы разобрали в статье про нейросети для музыки.
Какие задачи есть в разделе
У каждой задачи своя подборка с подробным сравнением. Здесь коротко: с чего начать.
Озвучка текста
Самая большая подборка раздела, 19 нейросетей: от недорогого диктора в Премиуме и 72 голосов Ультры до живой игры голосом в ElevenLabs Eleven v3 и диалога двух голосов в Gemini 3.1 Flash TTS и Gemini 2.5 Flash TTS. Для роликов на нескольких языках есть Inworld TTS 1.5 и Inworld Realtime TTS 2: один голос читает и по-русски, и на других языках. С чего начать, показано на шести голосах в статье про озвучку текста.
Музыка
Двенадцать нейросетей для песен и фона без слов. Suno самая популярная в разделе, у неё девять режимов, от песни по вашим стихам до кавера и мэшапа двух треков. Sonilo 1.1 попадает в длину ролика, Lyria 3 Pro пишет музыку по картинке, MiniMax Music 3.0 поёт по тексту с разметкой куплетов и припевов, а ElevenLabs Music v2.5 и v2 держат точную длину и берут плату за минуты. Lyria 3.5 от Google DeepMind поёт по-русски, сама сочиняет слова по описанию и даёт задать темп от 40 до 220 ударов в минуту, а длину не выбирает: трек выходит около трёх минут. У Mureka AI V9.5, которая появилась на сайте в октябре 2026 года, текст песни до 5000 знаков и можно выбрать мужской или женский голос. YuE2 3B умеет перепеть загруженную песню: сохраняет её мелодию и длину, а слова и жанр берёт ваши. Treblo поёт новую песню голосом или в звучании загруженной записи и умеет заменить в готовом треке одну строчку. Семь нейросетей, которые поют, мы сравнили на одной песне в подборке для музыки.
Звуковые эффекты и звук к видео
Шум дождя, скрип двери, удар или гул города по описанию делают в разделе «Звуковые эффекты». Там же Sonilo 1.1 для длинного фона, ElevenLabs Sound Effect V2 для коротких звуков с точной длиной, её новая версия ElevenLabs Sound Effect V3 для сцен из нескольких звуков и Mirelo AI SFX 1.6, которая продлевает и правит готовый звук. Mirelo SFX 2.0 делает эффект по описанию на русском и фон до пяти минут, а главное — озвучивает ролик до 10 минут, оставляя речь героев и убирая лишнюю музыку. Немой ролик загрузите в одну из нейросетей раздела «Звук для видео»: они сами подберут звук под то, что происходит в кадре. На коротком ролике дешевле всех MMaudio v2, для шорохов крупным планом есть ASMR-режим у Kling Video-to-Audio, а звук, которого нет в кадре (колокол, гром за окном), можно попросить у HunyuanVideo-Foley, задание лучше писать по-английски.
Очистка записи и расшифровка
Гул, ветер, разговоры за спиной убирают три нейросети для улучшения аудио: ElevenLabs Audio Isolation принимает и ролик (вернёт очищенный звук, его ставят вместо старой дорожки), DeepFilterNet3 дешевле и отдаёт WAV или FLAC для монтажа. VEED Clean Audio берёт запись или ролик до 30 минут и заодно выравнивает громкость голоса. Текст записи даёт Расшифровка аудио и видео: абзацами, по спикерам с таймкодами или файлом субтитров .SRT, а по готовому тексту она соберёт краткое резюме. Подробно в статье о расшифровке.
Что сделать с готовым треком
В подразделе «Инструменты» собраны четыре нейросети для готовых записей, и все они принимают любой ваш файл, в том числе записанный не на сайте. Песню Suno из сравнения мы прогнали через две из них.
Разделить на дорожки работала почти 4 минуты и вернула восемь файлов. Среди них пара «голос и минус», те же голос и музыка, разложенные на четыре дорожки (вокал, барабаны, бас, остальное), и картинка со структурой песни. Оплата за файл, а не за минуты, так что длинную песню делить не дороже короткой.
Голос отдельно
Минус без голоса
Структура песни
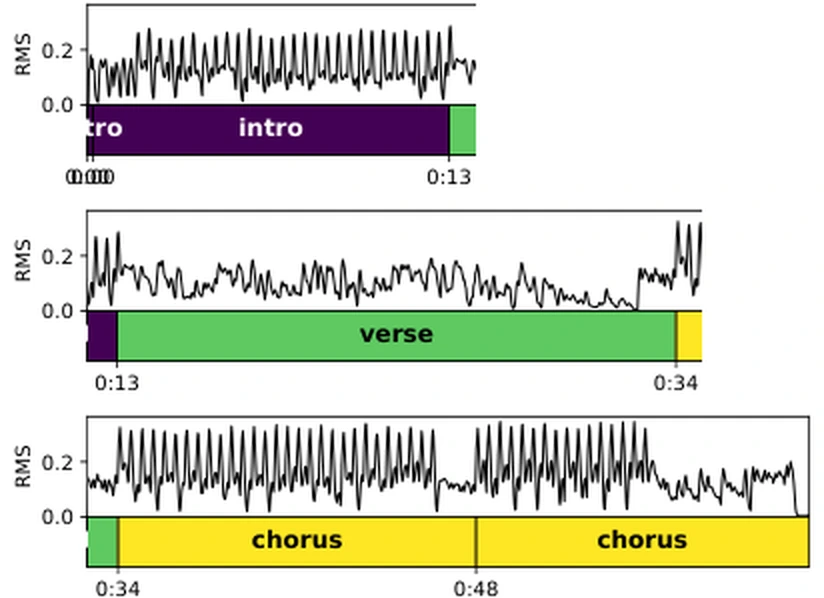
Разделить на дорожки · песня Suno из сравнения, 60 с · 6 ₽
Мы проверили дорожки распознаванием речи: в минусе не нашлось ни одного слова, в голосе нашлись все шесть строк. Голос вступает через 13 секунд, там же, где на картинке кончается intro (вступление). Сайт отдаёт картинку одной длинной полосой, мы разрезали её по времени на три строки, чтобы подписи читались с телефона. Минус нужен для караоке. Голос пригодится, чтобы положить его на другую музыку или отдать в Замену голоса.
Анализ аудио отвечает текстом на вопрос о записи. Платите за секунды записи. Минутную песню он разбирал 80 секунд.
Опиши эту песню: жанр, темп, инструменты, кто поёт и с каким настроением. Перескажи текст и скажи, для какого повода она подходит.
Из ответа: «Танцевальная поп-музыка с сильным влиянием современной эстрады… Ведущий инструмент: клавишные, играющие партию, которая очень напоминает аккордеон или баян… Вокал: мужской баритон… Эта песня… подходит для празднования 30-летнего юбилея мужчины по имени Сергей».
Анализ аудио · песня Suno из сравнения, без детального анализа · от 0,3 ₽/сек.
Текст пересказан верно, имя и возраст на месте. А вот инструменты в ответе не те, что мы заказывали: вместо акустической гитары и хлопков там клавишные «под баян», электрогитара и электронные барабаны. Ошибся анализ или Suno, решит только слух, поэтому включите песню выше и сравните. Для выжимки из созвона Анализ аудио не лучший выбор: секунда записи в Расшифровке намного дешевле, а её Резюме в проверке из статьи о расшифровке назвало бюджет созвона, который Анализ аудио пропустил.
Аудио-конвертер пересохраняет файл в MP3, WAV, AAC, FLAC, OGG, M4A или WMA. Он тоже берёт плату за секунды и нужен, когда площадка или монтажная программа не принимает ваш формат.
Свой голос: где сделать и для чего
Свой голос, который сохранится на сайте или пойдёт в песни и ролики, делают в четырёх нейросетях, у каждой своё назначение.
- Мега в режиме Клонировать голос берёт запись от 10 до 300 секунд. Клон оплачивается один раз, лежит в Моих голосах и читает текст с эмоциями.
- Mureka AI V9 в режиме Клонировать вокал делает голос для песен по фрагменту пения. Это самый дорогой клон на сайте, и мы его пока не проверяли.
- Замена голоса сначала учит модель голоса по записи на 5–30 минут (речь или пение, три качества тренировки), а потом меняет голос в песне или речи длиной от 30 секунд до 6 минут. Для песни есть готовые настройки «Чистый», «Точная копия модели» и «Мягкое пение».
- Kling Voice по записи или видео на 5–30 секунд делает голос для героев роликов Kling 3.0 и возвращает его номер. Номер вставляют в форме Kling 3.0 (в поле Версия вариант 2, в поле Тип генерации «Видео из текста»), подсказка у поля Voice IDs объясняет, как отметить реплики. Разработчик заявляет китайскую и английскую речь.
Для клона речи нужна чистая запись одного человека без музыки, эха и шума. Мега и Замена голоса попросят галочкой подтвердить, что это ваш голос или у вас есть согласие его владельца. Если голос нужен на один раз, клон не обязателен: Zonos2 и Qwen3 TTS берут образец прямо в запуск, а песню голосом из своей записи споёт Treblo в режиме Голос по образцу (из записи берётся до 75 секунд; здесь тоже только свой голос или с согласия владельца).
Главные нейросети раздела в одной таблице
Главные нейросети каждой задачи в порядке статьи. Остальные в карточках выше.
| Нейросеть | Цена | Задача | Что дать → что получить |
|---|---|---|---|
| Мега | 13 ₽ за 1000 символов | Озвучка | Текст до 10 000 символов → речь с эмоцией |
| Премиум | 1 ₽ за 1000 символов | Озвучка | Текст → речь диктора |
| Ультра | 2 ₽ за 1000 символов | Озвучка | Текст или TXT-файл → речь, 72 голоса |
| Suno | 10 ₽ за 2 трека | Музыка | Идея или свои стихи → два трека |
| Mureka AI V9 | от 7 ₽ | Музыка | Стихи и стиль → песня, фон без слов |
| Sonilo 1.1 | от 1.5 ₽/сек. | Музыка, эффекты | Описание или ролик → звук точной длины |
| ElevenLabs Sound Effect V3 | 0.5 ₽/сек. | Эффекты | Описание → звук или сцена из нескольких звуков |
| ElevenLabs Sound Effect V2 | 1.5 ₽ + 0.5 ₽/сек. | Эффекты | Описание → короткий звук |
| MMaudio v2 | от 0.2 ₽/сек. | Звук для видео | Немой ролик → ролик со звуком |
| Mirelo SFX 2.0 | 2.5 ₽/сек. | Звук для видео | Ролик до 10 минут → ролик с новым звуком, речь на месте |
| ElevenLabs Audio Isolation | 0.4 ₽/сек. | Очистка | Запись или ролик → звук без шума |
| DeepFilterNet3 | 0.2 ₽/сек. | Очистка | Запись → голос без гула, WAV или FLAC |
| VEED Clean Audio | 3 ₽/мин. | Очистка | Запись или ролик → чистый голос с ровной громкостью |
| Расшифровка аудио и видео | 0,01 ₽/сек. | Расшифровка | Аудио или видео → текст, SRT |
| Разделить на дорожки | 6 ₽ | Инструменты | Песня → голос, минус, 4 дорожки |
| Анализ аудио | от 0,3 ₽/сек. | Инструменты | Запись и вопрос → ответ текстом |
| Аудио-конвертер | 0.08 ₽/сек. | Инструменты | Файл → другой формат |
| Замена голоса | от 20 ₽ | Свой голос | Запись голоса и песня → песня вашим голосом |
Что выбрать под задачу
Поздравление голосом, объявление или аудиокнигу делайте в озвучке: Мега для эмоций, Премиум или Ультра для длинного текста. Песню в подарок начните в Suno, а если не понравилась, отправьте тот же текст в Mureka.
Звук для ролика собирают по частям. Закадровый голос делают в озвучке, фон в Suno с типом трека Инструментал или в Sonilo 1.1 точно по длине, шаги и удары в нейросетях для звука к видео, а ролик, где герой уже говорит, переозвучьте в Mirelo SFX 2.0 с включённым Сохранить речь. Голос, записанный на телефон, почистите в Audio Isolation, DeepFilterNet3 или VEED Clean Audio, а субтитры делайте в Расшифровке по исходной записи: после DeepFilterNet3 слова в нашей проверке распознались хуже.
Караоке и ремикс начинаются с нейросети Разделить на дорожки. Готовую песню своим голосом перепоёт Замена голоса. Если хотите спеть сами, запишите голос, а музыку подложит Suno в режиме Добавить инструментал. Длинные тексты своим голосом начитывает клон в Меге.
Вопросы о нейросетях для звука
Что почитать дальше: как писать промпты для музыки и песен, как клонировать голос и озвучить им текст и как создать звук для видео.
Статья обновлена 15 ноября 2026 г.