ByteDance Seed Audio 1.0 — нейросеть для озвучки текста на русском. Голос она подбирает сама, повторяет по вашей записи или придумывает по картинке, поэтому с ней удобно сделать голос персонажа: загрузите портрет героя и вставьте его реплику.
Коротко
- Разработчик
- ByteDance, исследовательское подразделение Seed
- На входе
- текст до 2000 символов, а в режимах с образцом или картинкой ещё 1–3 записи голоса или одна картинка
- На выходе
- запись MP3, 24 кГц; фраза в 170–190 символов звучит 11–17 секунд
- Голос
- готового списка нет: голос выбирает модель, берёт из образца или подбирает по картинке
- Русский язык
- говорит по-русски, в 11 наших записях распознавание речи нашло все слова текста
- Цена
- 50 ₽
- Обычно готово
- ≈ 40 с после отправки
Что умеет: три способа получить голос
Голос здесь можно взять из записи, доверить выбор модели или получить по картинке. Последнее особенно удобно, когда нужен голос персонажа: нейросеть смотрит на героя и решает, как он должен звучать. Мы разобрали 11 записей, сделанных для примеров этой страницы, по 3–4 на каждый вариант в поле Тип генерации. Текст каждой записи мы прогнали через программу распознавания речи, а высоту тона и паузы измерили по самим файлам. Интонацию замер не оценит. Её стоит послушать.
«Текст»: голос выбирает модель
В этом режиме нет ни списка голосов, ни поля для описания: в форму идёт только текст. Модель сама решает, кто его прочитает, и, похоже, смотрит на содержание. Сказку про ёжика прочитал низкий мужской голос, а рекламу кофейни, объявление в магазине и закадровый текст про горы — заметно выше, по замеру женский.
ByteDance Seed Audio 1.0 · сказка, 17 секунд · 50 ₽
ByteDance Seed Audio 1.0 · реклама, 13 секунд · 50 ₽
Жил-был в лесу маленький ёжик. Каждый вечер он выходил на поляну, смотрел на звёзды и считал их, пока не засыпал прямо в мягкой траве. А луна тихонько укрывала его своим серебряным светом.
Кофейня «Зерно» открылась на Садовой улице! Свежая обжарка каждый день, круассаны из печи и уютные кресла у окна. Покажите это сообщение бариста и получите второй капучино в подарок.
Сказку модель прочитала одним дыханием, без пауз дольше полсекунды. В рекламе между тремя фразами слышны короткие паузы, около трети секунды, а «двадцать процентов» в объявлении магазина прозвучали как надо. Голос не подошёл? Нажмите Повторить: каждый запуск модель читает заново.
«Голос из образца»: повторить тембр по записи
Сюда загружают от одной до трёх записей одного и того же человека, и модель читает ваш текст этим голосом. Наши образцы синтезированы в Меге, живых людей среди них нет. Ниже мужской образец и детектив по нему:
образец голоса, 16 секунд, создан нейросетью
ByteDance Seed Audio 1.0 · «Голос из образца» · 50 ₽
Инспектор медленно закрыл дверь и огляделся. В комнате пахло табаком и старыми газетами. На столе лежало письмо без подписи, а часы на стене остановились ровно в полночь.
Средняя высота тона в образце и в результате почти одна: 118 и 114 Гц. В образце рассказчик вспоминает приморский городок, старый маяк и рыбаков с уловом, а в результате читает совсем другой текст про инспектора и остановившиеся часы, и тембр при этом остался прежним.
С детским голосом тоже получилось. Образец — 25 секунд, где девочка Таня рассказывает про котиков и собаку Жучку. По нему модель прочитала поздравление маме, причём в результате тон стал даже чуть выше образца.
Мамочка, поздравляю тебя с днём рождения! Ты самая добрая и красивая. Я нарисовала тебе открытку с котиком и очень-очень тебя люблю!
ByteDance Seed Audio 1.0 · «Голос из образца», детский образец на 25 секунд создан нейросетью · 50 ₽
Повторять чужой голос можно только с согласия его владельца. Свой голос, голос друга, который не против, или синтезированный, как у нас, подойдут.
«По изображению»: голос персонажа по картинке
Среди озвучек сайта такой режим есть только здесь. Загружаете картинку с героем, и модель сама решает, как он звучит. Мы нарисовали в Z-Image мультяшного кухонного робота, никаких реальных людей на картинке нет.
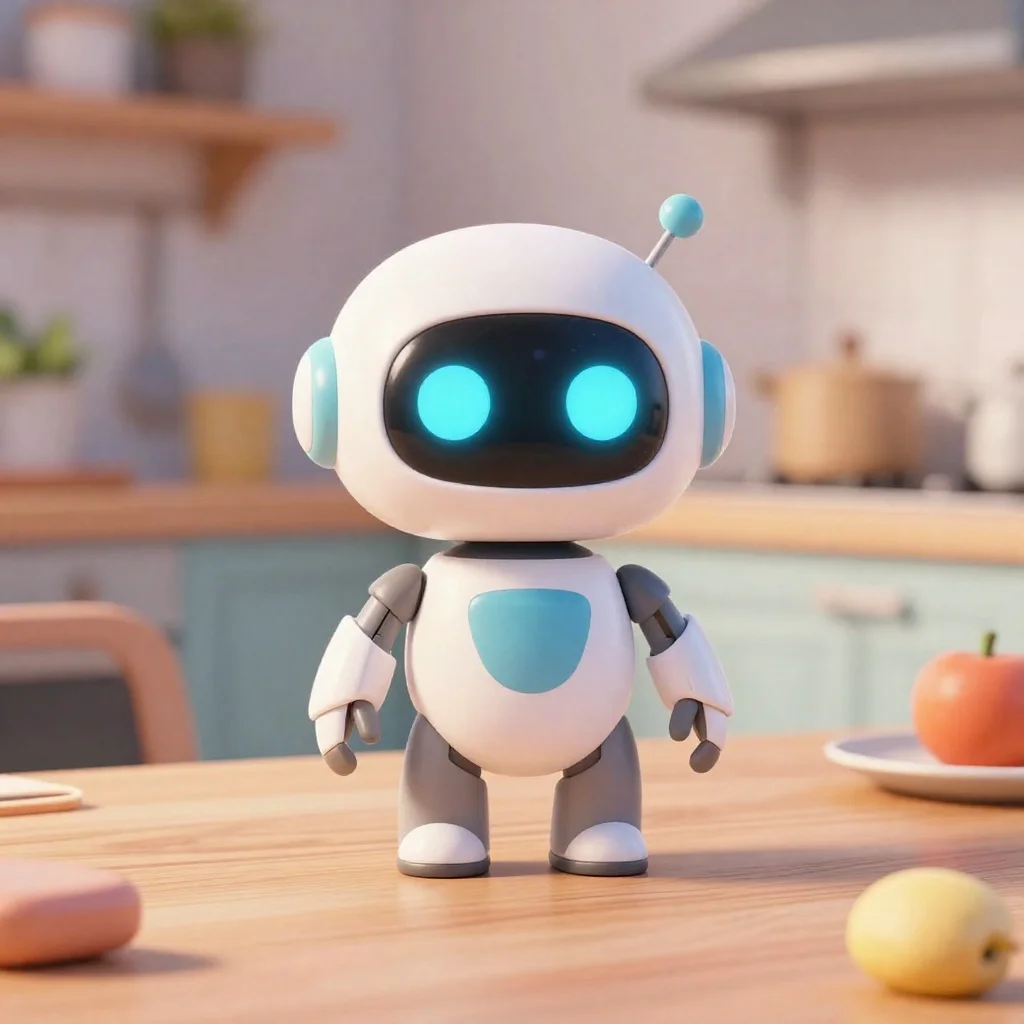
Привет! Я робот Бип, твой помощник на кухне. Сегодня приготовим блинчики! Возьми два яйца, стакан молока и немного муки. Не волнуйся, я всё подскажу!
ByteDance Seed Audio 1.0 · «По изображению», картинка создана нейросетью · 50 ₽
Робот зазвучал выше всех в наших записях, с короткими паузами между фразами. Людям на портретах модель в наших примерах подбирала голос по возрасту и образу. Вот средняя высота тона в четырёх наших пробах:
| Картинка | Что вышло |
|---|---|
| мультяшный робот | около 290 Гц, высокий, как у игрушки |
| бабушка в платке на крыльце | около 170 Гц, пожилой женский |
| седой гончар за кругом | 130–155 Гц, мужской |
| старый капитан с трубкой | около 120 Гц, низкий мужской |
Все четыре портрета созданы нейросетями сайта. Капитана можно послушать в статье «Озвучка текста», гончара — в обзоре нейросетей ByteDance, там его голос потом стал говорящим видео.
Как это работает
Выберите в поле Тип генерации один из трёх вариантов. «Текст» озвучит фразу, а диктора подберёт модель. «Голос из образца» попросит загрузить от одной до трёх записей в MP3, WAV или M4A, до 10 МБ каждая. «По изображению» попросит одну картинку в JPG, PNG, WebP или HEIC. Затем вставьте в поле Текст то, что нужно произнести, до 2000 символов. Модель читает его целиком и как есть, поэтому в поле должно быть только то, что прозвучит. В наших записях не пропало ни одного слова.
Переключатель Дополнительно открывает три ползунка: скорость речи, громкость и высоту голоса. Цена одна за любой запуск, она видна на кнопке Отправить. Результат ляжет в ленту под формой, у него будут кнопки Скачать, Изменить (текст и настройки вернутся в форму) и Повторить (то же задание запустится ещё раз). В Моих результатах запись хранится 7 дней, удачную сохраните в библиотеку.
Настройки: какие поля трогать
| Поле | Зачем | Что ставить |
|---|---|---|
| Тип генерации | откуда возьмётся голос | «Текст» для дикторской начитки без требований к голосу, «Голос из образца» для своего тембра, «По изображению» для персонажа |
| Образцы голоса | записи, с которых модель снимет тембр | по подсказке формы лучше всего 10–30 секунд чистой речи одного человека без музыки и шума; наши образцы были по 16–25 секунд |
| Изображение | герой, которому нужен голос | один персонаж крупно; возраст, характер и стиль (мультфильм или фото) должны читаться с первого взгляда |
| Текст | что произнести | до 2000 символов; реплику персонажа пишите от первого лица |
| Скорость речи | от 0,5 до 2, обычная 1 | 0,8–0,9 для сказки или урока, 1,1–1,2 для бодрой рекламы |
| Громкость | от 0,5 до 2, обычная 1 | 1; громкость удобнее выровнять при монтаже |
| Высота голоса | от −12 до 12, родная высота 0 | небольшой сдвиг, если голос хорош, но чуть высоковат или низковат |
Последние три ползунка спрятаны за переключателем Дополнительно. Пока он выключен, модель читает с обычной скоростью, громкостью и высотой. Во всех наших примерах он был выключен.
Как написать текст для озвучки
Текст пишется для уха. После точек и восклицательных знаков паузы в наших записях доходили до 0,9 секунды. Хорошая реплика собирается из трёх частей: обращение, суть, концовка с эмоцией.
Ну что, путешественник, добрался всё-таки! Дорога через перевал закрыта до утра, так что ночуешь у меня. Садись к огню, чай уже закипает.
Друзья, внимание! Через десять минут на главной сцене начинается концерт. Занимайте места поближе, а дети могут сесть прямо у сцены на ковриках.
Частые ошибки:
- Описание голоса в поле Текст. По словам разработчиков, модель понимает описания вроде «хриплый старик, говорит шёпотом», но в этой форме всё, что написано в поле, модель читает вслух, а отдельного поля для описания нет. Голос надёжнее задать картинкой или образцом.
- Образец с музыкой, эхом или двумя людьми. Модель возьмёт тембр с того, что услышит, и сходство пострадает. Нужна чистая запись одного голоса.
- Цифры, сокращения и телефоны. В наших текстах числа были написаны словами, и все прочитаны верно. Как модель читает цифры, мы не проверяли, поэтому важные числа надёжнее писать словами.
Сколько стоит
Плата берётся за запуск целиком. Длина текста, режим, число образцов и ползунки на цену не влияют, поэтому одна длинная реплика до 2000 символов выгоднее нескольких коротких.
| Тип генерации | Что загрузить | Цена |
|---|---|---|
| Текст | только текст | 50 ₽ |
| Голос из образца | текст и 1–3 записи | 50 ₽ |
| По изображению | текст и картинка | 50 ₽ |
Для чего подойдёт
- Сделать голос персонажа нейросетью для мультфильма, игры или сценки: нарисуйте героя и озвучьте его по картинке, как робота выше.
- Озвучить героя для говорящего видео: голос по портрету потом оживляют в OmniHuman 1.5.
- Прочитать текст своим голосом, когда записывать каждый дубль на микрофон некогда.
- Записать поздравление детским голосом, как в примере с мамой.
- Начитать сказку на ночь или закадровый текст для ролика о путешествии.
- Сделать голосовое объявление для магазина, кафе или мероприятия.
Чего модель не умеет и как это обойти
- Голос нельзя выбрать из списка. Нужен конкретный и одинаковый в каждом запуске — работайте с образцом или картинкой либо возьмите озвучку с готовыми голосами из раздела «Озвучка текста».
- Фоновых звуков в наших записях нет: в паузах тишина. Разработчики описывают модель как генератор целых звуковых сцен, но в 11 наших пробах был только голос. Шумы и эффекты лучше наложить отдельно.
- За раз не больше 2000 символов. Длинный текст делите на части и озвучивайте с тем же образцом или той же картинкой.
- Даже с одной и той же картинкой модель каждый раз читает немного по-разному: темп и паузы гуляют. Если запись пойдёт в ролик или поздравление, сделайте два-три запуска с одним и тем же текстом и выберите тот, где паузы и ударения легли лучше всего.
Чем отличается от Seed Speech и других озвучек
У ByteDance на сайте две озвучки. Seed Speech TTS 2.0 читает на 10 иностранных языках, русского у неё нет. Там 40 готовых голосов, подачу задают словами в отдельном поле, а платят по длине текста. Модель с этой страницы говорит по-русски, а голос в ней получают из записи или картинки. Английский ролик удобнее делать в Seed Speech, русский голос для героя — здесь. Все озвучки сайта с ценами собраны в разделе «Озвучка текста».
| Нейросеть | Цена | Русский | Чем отличается |
|---|---|---|---|
| ByteDance Seed Audio 1.0 | 50 ₽ | да | голос по картинке, по 1–3 образцам или на выбор модели |
| ByteDance Seed Speech TTS 2.0 | 10 ₽ за 1000 символов | нет | 10 иностранных языков, 40 голосов, подача словами |
| Zonos2 | 3 ₽ | да | голос по одной записи до 30 секунд, текст до 10 000 символов |
| Qwen3 TTS | 10 ₽ за 1000 символов | да | голос по словесному описанию или по записи |
| MiniMax Speech 2.8 | от 10 ₽ за 1000 символов | да | клон голоса хранится в «Моих голосах», теги смеха и вздохов |
Вопросы о голосе, оплате и API
Описание обновлено 2 октября 2026 г.
Голос гончара по портрету
Режим «По изображению»: голос подобран по портрету пожилого гончара, русская фраза.
Промпт: Глина любит терпение. Я сорок лет сижу за этим кругом, и ни один горшок не вышел похожим на другой. Вот этот, например, будет для мёда.
Детектив голосом из образца
Режим «Голос из образца»: одна запись мужского голоса на 16 секунд, и новый текст звучит тем же голосом.
Промпт: Инспектор медленно закрыл дверь и огляделся. В комнате пахло табаком и старыми газетами. На столе лежало письмо без подписи, а часы на стене остановились ровно в полночь.
Голос старого капитана по портрету
Режим «По изображению»: модель подобрала низкий мужской голос под фото моряка.
Промпт: Слушай, юнга. Море не прощает спешки. Сорок лет я водил корабли через шторма и туманы, и вот что я понял: главное — вовремя увидеть свет родного маяка.
Закадровый голос для тревел-ролика
Режим «Текст»: спокойная озвучка для видео о путешествии.
Промпт: Утро в горах начинается с тишины. Туман медленно сползает в долину, солнце золотит вершины, а в кружке остывает горячий чай. Ради таких минут и стоит отправляться в путь.
Голосовое сообщение подруге
Режим «Голос из образца»: запись женского голоса на 20 секунд.
Промпт: Катя, привет! Спасибо тебе огромное за вчерашний вечер, я так давно не смеялась. Давай в субботу снова встретимся, я знаю одно чудесное место с лучшими пирожными в городе.
Робот-помощник на кухне
Режим «По изображению»: высокий мультяшный голос под 3D-робота.
Промпт: Привет! Я робот Бип, твой помощник на кухне. Сегодня приготовим блинчики! Возьми два яйца, стакан молока и немного муки. Не волнуйся, я всё подскажу!
Реклама открытия кофейни
Режим «Текст»: короткий рекламный ролик для соцсетей или радио.
Промпт: Кофейня «Зерно» открылась на Садовой улице! Свежая обжарка каждый день, круассаны из печи и уютные кресла у окна. Покажите это сообщение бариста и получите второй капучино в подарок.
Детское поздравление маме
Режим «Голос из образца»: детский голос из записи на 25 секунд.
Промпт: Мамочка, поздравляю тебя с днём рождения! Ты самая добрая и красивая. Я нарисовала тебе открытку с котиком и очень-очень тебя люблю!
Бабушка рассказывает сказку
Режим «По изображению»: тёплый пожилой голос по фото бабушки с книгой.
Промпт: Садитесь поближе, внучата, расскажу вам сказку. Давным-давно в одной деревне жил кот Васька, и был он такой хитрый, что однажды обманул саму лису.
Сказка на ночь про ёжика
Режим «Текст»: неторопливое чтение для детей.
Промпт: Жил-был в лесу маленький ёжик. Каждый вечер он выходил на поляну, смотрел на звёзды и считал их, пока не засыпал прямо в мягкой траве. А луна тихонько укрывала его своим серебряным светом.