InfiniteTalk Video Multi — нейросеть MeiGen-AI, которая делает из видео диалог двух людей: человек слева произносит одну запись, человек справа — другую. Губы, взгляд и мимика каждого подстраиваются под его реплики, а фон и жесты остаются из вашего ролика.
Коротко
- Разработчик
- MeiGen-AI; модель открытая, построена на Wan 2.1 от Alibaba
- На входе
- один ролик (MP4, MOV, WebM, до 10 минут), где двое стоят или сидят рядом, и по записи голоса на каждого, вместе до 10 минут: MP3, WAV, M4A, FLAC и другие частые форматы
- На выходе
- MP4 длиной с диалог; у нас Fast дал кадр 640×352, «Обычная» с качеством 480p дала 848×464
- Звук
- в ролике звучат обе ваши записи, сведённые так, как выбрано в поле «Порядок»
- Русский язык
- губы подстраивает под русские записи; голоса не создаёт, записи нужны готовые
- Особенность
- каждому человеку своя дорожка: говорят по очереди или по вашим паузам
- Цена
- от 3 ₽/сек.
Что умеет: диалог двух людей в одном ролике
Обычный липсинк, то есть подгонка губ под звук, работает с одним голосом. Если в кадре двое, а запись одна, непонятно, чей рот должен двигаться. Эта нейросеть собирает диалог в видео из двух отдельных дорожек: Аудио слева достаётся человеку слева, Аудио справа — тому, кто справа (стороны считаются так, как вы смотрите на экран). MeiGen-AI выложила модель в августе 2025 года, и режим для нескольких говорящих у неё описан отдельно. Ниже три пробы на одном и том же ролике.
Исходник сделан на сайте, этих людей не существует. Кадр с девушкой и парнем за столиком кафе нарисовала GPT Image 2, ролик из него сняла Grok Video 1.5: 10 секунд, 1280×704, оба молча улыбаются, парень берёт чашку. Голоса тоже синтезированы, а не записаны с живых людей.
Реплики по очереди
Готовый пример со страницы. Две фразы озвучили в нейросети Мега: вопрос парня («Слушай, ты уже купила билеты на поезд до Питера?», 4,1 секунды) лёг в поле Аудио справа, ответ девушки («Купила. Места у окна, едем в пятницу вечером», 3,9 секунды) — в Аудио слева. В поле Порядок выбрали «Справа → слева», чтобы первым спросил парень. Режим Fast.
исходник, 10 секунд без речи
InfiniteTalk Video Multi · Fast, «Справа → слева» · от 3 ₽/сек.
Вышло 8 секунд, две фразы подряд, а последние две секунды исходника нейросеть отбросила. Распознавание речи услышало оба предложения в нужном порядке. Пока говорит парень, девушка слушает с закрытым ртом.
Жесты взяты из исходника, но не копией кадр в кадр: лица и позы нарисованы заново, и кадр результата с кадром оригинала один в один не совпадает.
Три реплики через «Одновременно»
По очереди звучат только две записи, значит и реплик две. Для живого разговора есть приём с паузами в дорожках, его подробно разобрали на фото в статье InfiniteTalk Multi, а здесь проверили на готовом видео. Три короткие фразы озвучили в ElevenLabs v3 голосами Alice и Brian, а потом склеили две дорожки одинаковой длины, 5,9 секунды. На левой девушка спрашивает, молчит, пока отвечает парень, и договаривает. На правой тишина, ответ парня и снова тишина.
Левая дорожка:
Правая дорожка:
Реплики: «А зарядку ты взял?», «Взял. И бутерброды тоже!», «Ну всё, едем!» Поле Задание пустое.
InfiniteTalk Video Multi · Fast, «Одновременно» · от 3 ₽/сек.
Ждали около двух с половиной минут. При «Одновременно» длина ролика равна более длинной дорожке, так что получилось те же 5,9 секунды. Все три фразы стоят на своих местах.
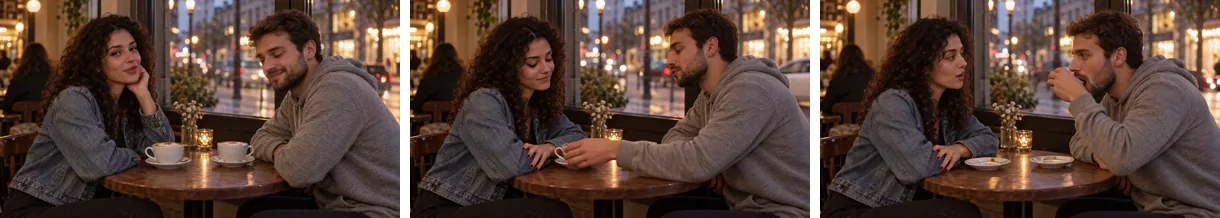
По кадрам видно, что тишина в дорожке работает: пока говорит один, второй держит рот закрытым и улыбается. На последней фразе девушка повёрнута к собеседнику вполоборота, и губы всё равно двигаются под слова. А парень в эту секунду подносит чашку ко рту, потому что так было в исходнике. Совпади его реплика с глотком кофе, получилось бы странно, так что паузы удобнее расставлять, глядя на исходный ролик.
Fast или «Обычная»
Те же видео и дорожки мы прогнали в режиме «Обычная» с качеством 480p. Ждать пришлось дольше, около трёх минут.
InfiniteTalk Video Multi · Fast, 640×352 · от 3 ₽/сек.
InfiniteTalk Video Multi · Обычная, 480p (848×464) · от 3 ₽/сек.
Диалог в обоих роликах одинаковый, реплики стоят на тех же местах. Разница в кадре. В форме у Fast стоит «480p», а на деле он присылает 640×352, тогда как «Обычная» 480p присылает 848×464. На телефоне это почти незаметно, зато на экране ноутбука видно сразу, что в Fast кудри девушки сливаются в одно пятно, а огни за окном расплываются. Увеличенный кусок кадра:
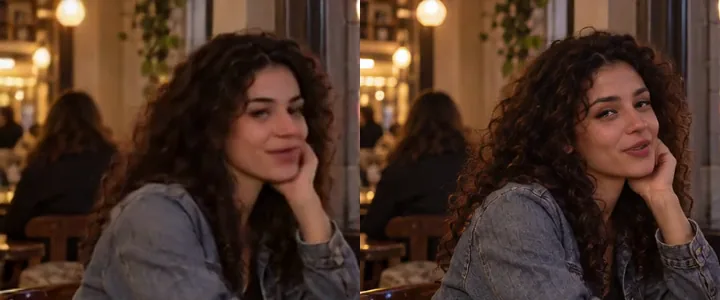
Позы в двух роликах тоже чуть разные: модель каждый раз рисует сцену заново. 720p мы не запускали.
Как это работает
Нужен ролик, где двое стоят или сидят рядом. Запись того, кто слева, кладите в Аудио слева, запись соседа — в Аудио справа. Разработчики пишут, что модель опирается на отдельные кадры исходника и перерисовывает сцену под звук целиком, вместе с выражением лица и поворотом головы. Обстановка, одежда и движения рук остаются из вашего видео.
Поле Порядок решает, как сводятся две записи. «Слева → справа» и «Справа → слева» ставят их одну за другой, и ролик длится как обе вместе. «Одновременно» запускает обе с нуля, и ролик длится как более длинная: так собирают разговор из трёх и больше реплик, как в пробе выше.
Сколько длится результат, решают записи: если видео длиннее, конец отрезается, поэтому берите исходник не короче диалога. Голоса она не придумывает, ей нужны готовые записи: свои, дикторские или синтезированные. Когда обе дорожки загружены, сумма видна на кнопке Отправить. Результат появится в ленте над статьёй и будет храниться неделю в Моих результатах, а чтобы он не пропал, скачайте его или добавьте в библиотеку.
Настройки: порядок реплик и качество
| Поле | Что задаёт | Совет |
|---|---|---|
| Режим | скорость и чёткость | Fast для проверки таймингов, «Обычная» для финала |
| Качество | 480p или 720p, второе только в «Обычной» | 720p, если ролик будут смотреть на большом экране |
| Видео | ролик до 10 минут, двое в кадре | оба лица видны, люди не меняются местами и не заслоняют друг друга |
| Аудио слева | реплики человека слева (если смотреть на экран) | только голос, без музыки и фонового гула |
| Аудио справа | реплики человека справа | то же; обе записи вместе — не длиннее 10 минут |
| Порядок | «Одновременно», «Слева → справа» или «Справа → слева» | по очереди, когда реплик две; «Одновременно», когда паузы расставлены в дорожках |
| Задание | подсказка словами про манеру речи | можно не заполнять, во всех наших пробах оно было пустым |
Две дорожки: как расставить реплики
Губы двигаются, пока в дорожке есть голос. Поэтому всю режиссуру диалога задают записи, настройки тут почти ни при чём.
- Напишите реплики и озвучьте каждую отдельно, например в одной из нейросетей озвучки текста. Голоса берите разные, чтобы было слышно, кто говорит.
- Если реплик две, загрузите их как есть и выберите «Слева → справа» или «Справа → слева».
- Если реплик больше, соберите две дорожки одинаковой длины с тишиной на месте чужих фраз, как в пробе в кафе, и поставьте «Одновременно».
- Сверьте паузы с исходником: реплика должна попадать на момент, когда человек смотрит на собеседника или в камеру.
- Сначала прогоните диалог в Fast, а когда тайминги устроят, запускайте «Обычную».
Задание можно оставить пустым. Если хочется подсказать манеру, пишите про обоих сразу: мы такое не проверяли, так что считайте это отправной точкой.
Двое говорят дружелюбно и спокойно, слушающий кивает и улыбается.
Сколько стоит диалог
Оплачиваются секунды готового ролика. По очереди это сумма двух записей, при «Одновременно» берётся длина более длинной. Сколько длится исходное видео, для цены неважно, дробные секунды округляются в большую сторону, а всё, что короче пяти секунд, оплачивается как пять.
| Режим | Качество | Записи и порядок | Цена |
|---|---|---|---|
| Fast | — | 2 + 2 секунды по очереди (считается как 5) | 15 ₽ |
| Fast | — | 4 + 4 секунды по очереди | 24 ₽ |
| Fast | — | две дорожки по 6 секунд, «Одновременно» | 18 ₽ |
| Обычная | 480p | 4 + 4 секунды по очереди | 48 ₽ |
| Обычная | 720p | 4 + 4 секунды по очереди | 96 ₽ |
| Fast | — | минутный диалог, «Одновременно» | 180 ₽ |
| Обычная | 720p | минутный диалог, «Одновременно» | 720 ₽ |
При «Одновременно» оплачивается и тишина в конце дорожки, поэтому обрезайте обе по последней фразе. Для проб таймингов хватает Fast.
Для чего подойдёт
- Озвучить видео разными голосами: двое героев, снятых видеонейросетью, говорят ваш текст по-русски.
- Скетч или сценка для соцсетей с вопросом и ответом, как в кафе выше.
- Дубляж диалога: интервью или подкаст двух ведущих в кадре на другом языке.
- Ролик для урока: «продавец» и «покупатель» разыгрывают диалог на иностранном языке.
- Реклама в формате «вопрос клиента — ответ консультанта» без съёмки актёров.
- Заменить испорченную реплику одного из двоих, не переснимая сцену.
Где диалог может не сложиться
- Говорящих ровно двое, по одной дорожке на каждого. Хор, третий голос или смена людей в кадре этой модели не по силам; как модель ведёт себя с третьим человеком в кадре, мы не проверяли.
- Модель ориентируется на стороны кадра, а не на лица. Если люди меняются местами или камера переходит между планами, голос может «уехать» к соседу; такие ролики мы не пробовали, но лучше снимать двоих с одной точки.
- Жесты идут по исходнику. Если человек в нужную секунду пьёт, жуёт или закрывает лицо рукой, реплика попадёт на это движение — передвиньте паузу.
- У Fast кадр меньше заявленных 480p. Для ноутбука и большого экрана берите «Обычную».
- Если в кадре двое, а говорить должен один, попробуйте InfiniteTalk Video с одной записью: у неё есть поле Маска, чтобы отметить нужного человека. Как это работает с двумя людьми, мы не проверяли.
- Чужие лица и голоса берите только с согласия людей. В наших пробах все герои и голоса выдуманные.
Чем Video Multi отличается от соседних версий
У InfiniteTalk на сайте четыре версии. InfiniteTalk Video меняет речь одного человека в ролике. Video Multi добавляет вторую дорожку и поле Порядок, поэтому подходит для разговора. Если видео нет, а есть только картинка с двумя героями, нужна InfiniteTalk Multi: движения она придумает сама. InfiniteTalk оживляет одно фото под один голос. Другие модели липсинка мы прогнали на одном ролике в разделе «Липсинк». Формы четырёх версий:
| Нейросеть | Цена | На входе | Кто говорит | Режимы и кадр |
|---|---|---|---|---|
| InfiniteTalk | от 3 ₽/сек. | фото и одна запись до 10 минут | один человек | «Обычная»: 480p или 720p; «Быстрая»: кадр меньше 480p, у портрета 3:4 вышло 400×544 |
| InfiniteTalk Multi | от 3 ₽/сек. | фото и две записи, вместе до 10 минут | двое, слева и справа: по очереди или одновременно | «Обычная»: 480p или 720p; Fast: только 480p, у фото 16:9 вышло 640×352 |
| InfiniteTalk Video | от 3 ₽/сек. | видео до 10 минут и одна запись до 10 минут, по желанию маска | один человек | Fast: только 480p, у ролика 16:9 вышло 640×352; «Обычная»: 480p или 720p |
| InfiniteTalk Video Multi | от 3 ₽/сек. | видео до 10 минут и две записи, вместе до 10 минут | двое, слева и справа: по очереди или одновременно | Fast: только 480p, у ролика 16:9 вышло 640×352; «Обычная»: 480p или 720p |
Диалог из одного фото двух людей делает и модель другого разработчика:
| Нейросеть | Цена | Что делает | Когда брать |
|---|---|---|---|
| LongCat Avatar 1.5 Multi | от 6 ₽/сек. | фото двух человек и две дорожки; по очереди или одновременно; 480p или 720p | видео нет, нужен ещё один вариант диалога из снимка |
Частые вопросы
Описание обновлено 20 октября 2026 г.