Коротко
- Разработчик
- ByteDance, научная статья о модели вышла в январе 2026 года
- На входе
- одна картинка (JPG, PNG или HEIC до 4,7 МБ) и ролик-образец MP4, MOV или WebM до 30 секунд
- На выходе
- ролик длиной с образец и в пропорциях картинки; у нас длинная сторона выходила 1120–1242 точки
- Кто двигается
- люди, звери, рисованные и мультяшные герои, несколько героев в одном кадре
- Звук
- только тот, что был в образце: речь, музыка или шум из вашего видео
- Русский язык
- поля для задания нет; русская речь из образца остаётся в ролике
- Цена
- 8 ₽/сек.
- Обычно готово
- ≈ 3,5 мин после отправки
Двое зверей, говорящий портрет и кот: наши пробы
У DreamActor V2 нет ни поля для текста, ни настроек. Картинка решает, кто в кадре и где он стоит, ролик решает, как он двигается. Мы проверили то, что разработчики называют её сильными сторонами: сцену с двумя героями и крупный план лица, на этот раз с речью. Реальных людей здесь нет: и героев, и людей для образцов нарисовала Nano Banana 2 Lite, а образцы из этих картинок сняла Grok Video 1.5.
Двое героев, у каждого своё движение
Сначала нужен образец, где двое делают разное. Парень и девушка стоят рядом в пустой студии: он машет обеими руками над головой, она в это время делает оборот на месте, потом оба поворачиваются друг к другу и дают пять. Ролик вышел на 5,04 секунды, и мы обрезали его до 4,88: сайт округляет секунды вверх, лишние четыре сотых обошлись бы как целая секунда. Звук тоже убрали, в нём был только фоновый шум. Задание для образца было таким:
Парень и девушка с картинки двигаются по-разному. Парень широко машет обеими руками над головой, а девушка в это же время делает полный оборот на месте. Потом оба поворачиваются друг к другу и дают пять, затем снова смотрят в камеру. Камера неподвижна, один непрерывный план без склеек, оба всё время видны целиком от головы до ног. Тихо, без музыки и без речи.
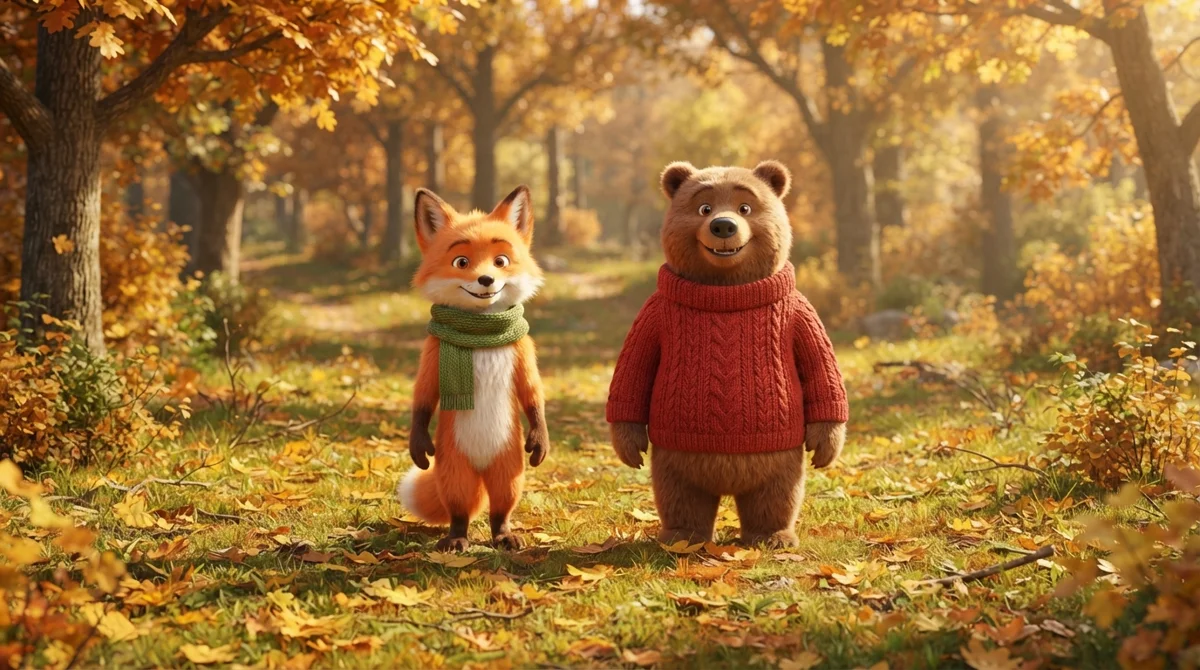
Героями стали лис в зелёном шарфе и медведь в красном свитере, оба в полный рост на осенней поляне, стоят так же, как люди в образце: лис слева, медведь справа.
Grok Video 1.5 · образец, 720p, 4,88 с · от 2 ₽/сек
DreamActor V2 · результат, 5 с к оплате · 8 ₽/сек.
Модель не перепутала, кто есть кто. Лис машет лапами, как парень, медведь крутится, как девушка, и в конце они сходятся и хлопают лапой о лапу. Фон, свитер и шарф остались с картинки, поляна не поплыла. Ролик пришёл через 2 минуты 20 секунд.
Есть и промах. Спину медведя картинка не показывала, и на обороте у него вырос пушистый рыжий хвост с белым кончиком, точь-в-точь лисий. Хвост так и остаётся до конца ролика, просто анфас его почти не видно. Всё, что скрыто на картинке, нейросеть дорисовывает сама и в сцене с несколькими героями может взять деталь у соседа. Если персонаж будет поворачиваться спиной, нарисуйте его так, чтобы спина или хвост хоть немного были видны, либо выбирайте образец без разворотов.
Портрет маслом заговорил чужим голосом
Вторая проба — крупный план с речью. Образец сняли в 480p, это вертикаль всего 448×672 точки, и для мимики этого хватило:
Женщина с картинки говорит прямо в камеру по-русски тёплым живым голосом: «Здравствуйте! Мне почти двести лет, а я всё ещё улыбаюсь». Во время речи удивлённо поднимает брови, на последних словах широко улыбается и чуть наклоняет голову, моргает. Камера неподвижна, один непрерывный план, лицо всё время в кадре. Без музыки.
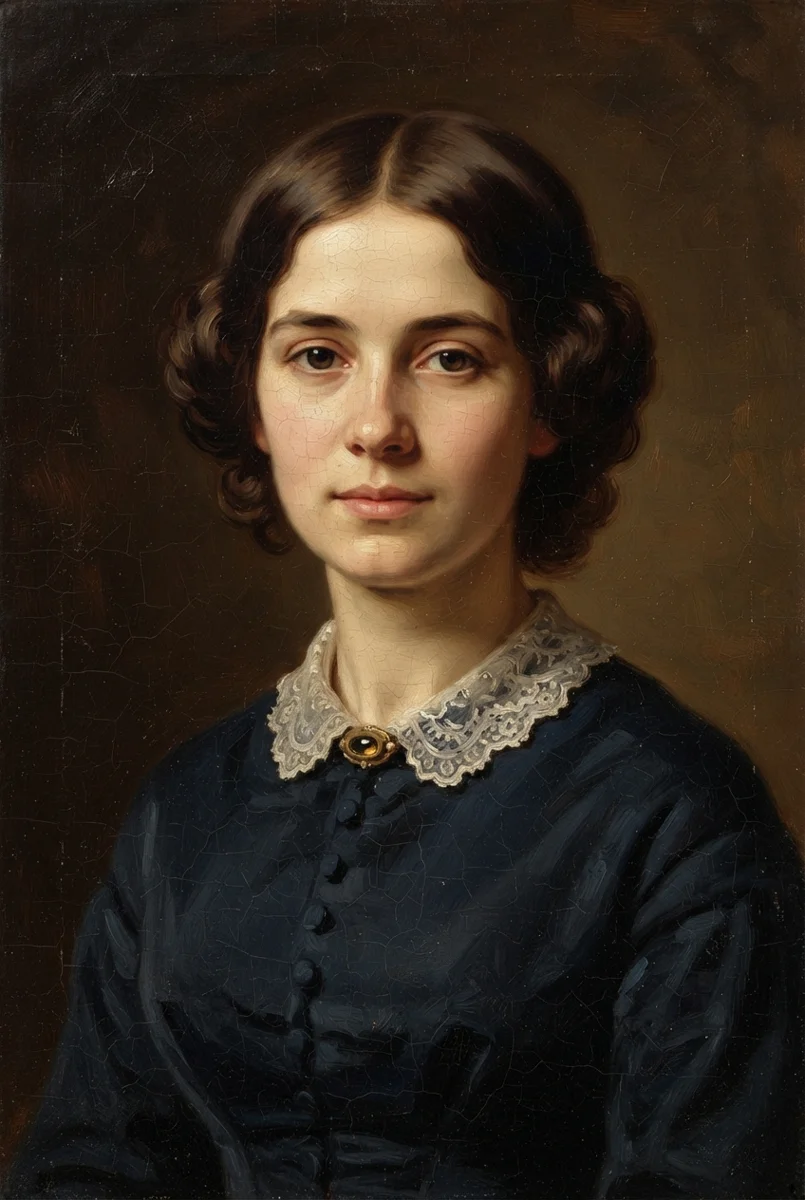
Героиня — выдуманная девушка в платье XIX века, портрет маслом.
Grok Video 1.5 · образец, 480p, 4,88 с · от 2 ₽/сек
DreamActor V2 · результат, 5 с к оплате · 8 ₽/сек.
Портрет повторил почти всё: поднятые брови, моргание, наклон головы, улыбку на последних словах. Голос остался из образца, и программа распознавания речи разобрала фразу слово в слово. Получилась говорящая картина.
Кружевной воротник и брошь не поплыли, а вот мазки и трещинки лака на лице стали мягче, и кожа местами выглядит гладкой, почти как на фото.
Ещё одна деталь: ролик начинается не с картинки. На портрете рот закрыт, а в первом кадре девушка уже улыбается и говорит, потому что так начинался образец. Нужен спокойный первый кадр? Начните образец с нейтрального лица. Ролик был готов через 3 минуты 18 секунд, высота кадра выросла до 1120 точек: размер результата берётся от картинки, а не от образца.
Рисованный кот и танец
Этот пример уже есть на странице нейросети среди готовых. Плоского мультяшного кота нарисовала Nano Banana 2, а танец девушки в белой футболке сняла Grok Video 1.5, так что и здесь реальных людей нет.
Grok Video 1.5 · образец, 5 с · от 2 ₽/сек
DreamActor V2 · результат, 5 с · 8 ₽/сек.
У кота короткие лапы и круглое тело, а у девушки длинные руки, но поза не сломалась: он вскидывает лапы вверх, прижимает их к груди и разводит в стороны, сохраняя свои пропорции. Контур остался плоским, как на рисунке, и хвост на месте. Хуже всего вышли лапы, поднятые над головой: подушечки на секунду смазываются в серое пятно. Звук образца перешёл и в этот ролик.
Как это работает
В форме два обязательных поля. В поле Изображение загружают картинку с героем, в поле Видео кладут ролик, где кто-то делает нужное: говорит, танцует, машет, ходит. Текста писать не нужно, его просто некуда вписать: внешность, одежду и фон нейросеть берёт с картинки, а позы, мимику, повороты головы и темп — из видео.
Оплата идёт по секундам образца. Длину ролика форма определяет при загрузке, дробные секунды доводит до целой, и сумма появляется на кнопке Отправить ещё до запуска. Сколько обычно ждать, написано в «Коротко». Результат встанет в ленту под формой, а в разделе Мои результаты пролежит неделю: скачайте его или сохраните в библиотеку, чтобы не пропал. Изменить вернёт запуск в форму, Повторить сразу отправит его ещё раз.
Длина результата равна длине образца, пропорции — как у картинки. Звук ролик берёт из образца как есть: музыку, речь, шум. Если образец был беззвучным, результат тоже будет без звука.
Настройки: какие файлы загрузить
Настраивать нечего, поэтому всё решают два файла.
- Изображение: JPG, PNG или HEIC, один файл до 4,7 МБ. В подсказке формы разрешение от 480×480 до 1920×1080; вертикальная картинка 848×1264 у нас прошла без вопросов. Героя видно целиком и ничем не закрыто, вокруг есть место для движений.
- Видео: MP4, MOV или WebM, один файл до 30 секунд, от 200×200 до 2048×1440 точек. Один непрерывный план без склеек, камера по возможности неподвижна. Высокое разрешение образцу не нужно, хватает 480p.
Что мы поняли на своих запусках:
- Крупность и расстановка должны совпадать. Наши лис и медведь стояли там же, где парень и девушка, поэтому движения разошлись по героям правильно. Для говорящего портрета берите образец тоже по плечи.
- Число героев на картинке и людей в образце лучше делать одинаковым. Сцены, где в образце двое, а на картинке один (или наоборот), мы не проверяли.
- Первый кадр образца станет первым кадром результата, поэтому стартовую позу задаёт видео, а не картинка.
- Следите за сотыми долями: наш образец на 5,04 секунды стоил бы как шестисекундный, а после обрезки до 4,88 стал пятисекундным.
- Ненужную музыку или чужую речь уберите из образца заранее, иначе они окажутся в результате.
- Свой образец проще всего сгенерировать: нарисовать выдуманного человека в картиночной нейросети и оживить его видеонейросетью, как сделали мы. В чужом ролике чужое лицо и чужая музыка, а для публикации это лишний риск.
Подробный разбор подготовки образца есть в инструкции как перенести движения с видео на своего персонажа.
Цена: платите за секунды образца
Цена зависит только от длины видео-образца: секунды считаются с округлением вверх, картинка на цену не влияет.
| Длина образца | Цена |
|---|---|
| 3 с | 24 ₽ |
| 5 с, как в наших пробах | 40 ₽ |
| 10 с | 80 ₽ |
| 15 с | 120 ₽ |
| 30 с, самый длинный | 240 ₽ |
Для первой пробы вырежьте из образца 3–5 секунд с самым сложным движением: так сразу видно, держит ли нейросеть героя на поворотах. Полный ролик — когда проба понравилась. Если запуск сорвётся по вине нейросети, списанное вернётся на баланс автоматически.
Для чего подойдёт
- Говорящий портрет, картина или иллюстрация повторяет вашу речь и мимику, как наша девушка в платье XIX века.
- Двое маскотов бренда здороваются и дают пять в начале ролика (см. лиса и медведя выше).
- Мультяшный зверь повторяет трендовый танец из короткого видео.
- Персонаж детской книжки или игры показывает жест или эмоцию, которую вы сыграли сами.
- Быстрый черновик анимации: посмотреть, как герой «играет» в кадре, прежде чем заказывать ручную анимацию.
- Оживить детский рисунок — по шагам это разобрано в отдельной инструкции.
Где модель ошибается и что делать
- Задание словами не дать: поменять фон, свет или одежду можно только на самой картинке. Перерисуйте её заранее в картиночной нейросети, например в Nano Banana 2.
- То, чего не видно на картинке (спина, хвост, руки за спиной), нейросеть придумывает и может взять у соседнего героя, как медведь с лисьим хвостом.
- Образец — до 30 секунд. Для длинных роликов есть Wan 2.2 Animate (до 120 секунд) и Wan Motion (до 10 минут).
- Разрешение не выбирается: в наших роликах длинная сторона была 1120–1242 точки. Если нужен 1080p, возьмите Kling 3.0 Motion Control.
- Свой звук модель не делает, только переносит звук образца. Озвучить героя другим голосом лучше в OmniHuman 1.5: там ролик собирается по записи голоса.
- Поставить героя в чужое готовое видео вместо человека она не умеет. Для замены человека в ролике есть Wan 2.2 Animate в режиме «Замена персонажа».
- Мелкие детали на быстрых движениях смазываются: у кота на секунду пропали подушечки лап. Спокойный темп образца переносится чище.
Kling, Wan и OmniHuman: чем отличаются
Перенос движения на сайте делают несколько нейросетей. У этой модели нет поля задания и выбора разрешения, зато, по словам разработчиков, она рассчитана на несколько героев в кадре и на нечеловеческих персонажей. Один и тот же танец на восьми нейросетях сравнили в обзоре нейросетей для переноса движения, а остальные модели ByteDance собраны в обзоре ByteDance.
| Нейросеть | Цена | Что делает | Когда брать |
|---|---|---|---|
| DreamActor V2 | 8 ₽/сек. | оживление без задания и настроек, разрешение по картинке, видео до 30 с | несколько героев в кадре, звери и рисованные персонажи, говорящий портрет |
| Kling 3.0 Motion Control | от 18 ₽/сек. | оживление с полем задания, 720p или 1080p, образец 3–30 с | короткий ролик в 1080p |
| Wan 2.2 Animate | от 8 ₽/сек. | оживление и замена героя, 480p или 720p, видео до 120 с | героя нужно поставить в сцену из ролика |
| Wan 2.2 Animate 2 | от 6 ₽/сек. | только оживление, поля для внешности и движения, Seed, 480p или 720p, видео до 120 с | один герой на своём фоне, крупность и камера как в образце |
| Wan Motion | от 10 ₽ | оживление с подгонкой под фигуру героя, 720p, видео до 10 мин | герой сложён не как человек в ролике, длинный ролик |
| OmniHuman 1.5 | 35 ₽/сек. | говорящее фото по записи голоса | герой должен говорить или петь, а видео-образца нет |