Коротко
- Разработчик
- ByteDance, код модели открыт
- На входе
- ролик (MP4, MOV, WebM) и звуковой файл (MP3, WAV, M4A, AAC, FLAC, OGG, OPUS), оба не длиннее 10 минут
- На выходе
- MP4 с вашим звуком, кадр меньше исходного: у нас 1280×720 стал 832×464
- Настройки
- полей, кроме двух файлов, нет
- Русский язык
- голос не создаёт, губы подстраивает под русский звук
- Запись длиннее видео
- звук не обрезается, недостающие кадры модель дорисовывает
- Цена
- 5 ₽/сек.
Губы точные, картинка мягче: проба рядом с Sync Lipsync 2.0
LatentSync в 2024 году описали исследователи ByteDance, а код выложили в открытый доступ. Модель занимается только синхронизацией губ с аудио: она смотрит на лицо в готовом видео, слушает новую запись и перерисовывает рот так, чтобы человек будто произносил эти слова. Голову, глаза, фон и жесты она оставляет из исходника.
Сравнивать удобнее на знакомом материале, поэтому файлы мы взяли из нашей статьи о липсинке и положили рядом ролик Sync Lipsync 2.0, сделанный на них же. В исходнике 1280×720 выдуманный столяр Пётр по-английски хвалит свою табуретку и между фразами слегка улыбается в камеру. Лицо ему придумала Nano Banana 2 Lite, сняла ролик Grok Video 1.5. Модели ByteDance достались первые 4 секунды без звука и русская фраза на 3,8 секунды голосом Bill из ElevenLabs v3.
Я Пётр. Эту табуретку я собрал без гвоздей.
Bytedance LatentSync · видео 4 с, запись 3,8 с · 5 ₽/сек.
Sync Lipsync 2.0 · модель Lipsync 2, те же файлы · от 10 ₽/сек.
Ролик пришёл через 74 секунды. Распознавание речи вернуло фразу полностью, не перепутав ни слова. Мы прошли его по кадрам: губы сходятся в начале имени и посередине слова «собрал», где и звучат «п» и «б». С синхронностью всё в порядке. Картинка другая: кадр уменьшился до 832×464, кожа стала глаже, морщины у глаз мягче. Рот модель открывает скромнее, чем Sync, а вместо зубов рисует светлую размытую полосу.
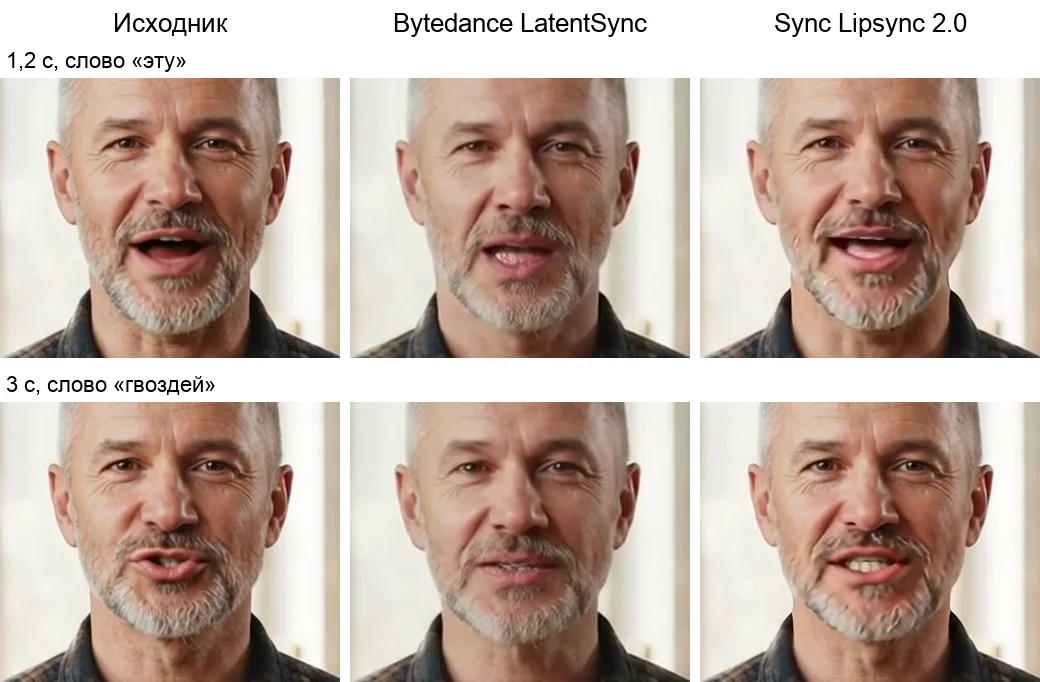
Зато у бороды нет рваного края, который Sync оставляет вдоль челюсти. Подмену здесь выдаёт скорее общая мягкость лица, чем шов вокруг рта. На экране телефона мы бы её не заметили. На ноутбуке во весь экран уже видно, что ролик стал мутнее исходника. Разработчики сами писали о размытости и в версии 1.6 (июнь 2025 года) перешли на обучение по кадрам 512×512, чтобы с ней справиться.
Влог с жестами
Для статьи о липсинке мы давали модели ещё один ролик: выдуманная Марина рассказывает о себе за рабочим столом, много жестикулирует и поворачивает голову. Запись была на 9 секунд, тоже из ElevenLabs v3. Рот и тут попадал в слова, а руки и повороты головы остались как в исходнике.
Запись вдвое длиннее видео
Выбрать, что делать с разной длиной, в форме нельзя. Мы взяли крайний случай. Тот же 4-секундный кусок с Петром и новая фраза на 8,2 секунды, тем же голосом:
Табуретку я делал два вечера: дуб, столярный клей и немного терпения. Садитесь смело, она выдержит.
Звук не обрезался: ролик длится 8 секунд, и распознавание снова вернуло фразу целиком. Видео не пошло по кругу. Вторую половину нейросеть досочинила: Пётр подаётся к камере и взмахивает рукой у груди, хотя в исходнике рук в кадре нет вообще. Выглядит это естественно, но около четвёртой секунды, где кончается исходник, заметен небольшой рывок. Губы попадают в слова и здесь: на «б» в «дуб» и на «м» в «смело» рот закрыт. Ждали 107 секунд.
Списали за 9 секунд записи (8,2 округляются вверх), а за видео отдельно ничего не взяли. Выходит, под длинную реплику годится и короткий кусок видео, только лишние жесты будут на совести модели. Для рекламы и всего, где важен каждый кадр, видео лучше снять не короче записи.
Как это работает
Нужны два файла: ролик с человеком и звук, под который он должен шевелить губами. Ролик кладут в поле Видео, звук — в поле Аудио. Дальше модель слушает запись и кадр за кадром рисует заново рот и подбородок. Глаза, причёска, фон, руки и движения головы берутся из исходника, а исходная речь заменяется вашей записью.
Сама модель не говорит. Если записи пока нет, текст сначала озвучивают: своим голосом, голосом диктора или нейросетью. Секунды файлов форма считает сама, как только они загрузятся, и сумма появляется на кнопке Отправить ещё до запуска; платят за длину звука. Готовое видео приходит в ленту под формой и хранится в Моих результатах 7 дней, дольше — если сохранить его в библиотеку. Забрать файл можно кнопкой Скачать. Изменить вернёт задание в форму, если хочется поменять запись, а Повторить отправит его заново и снова спишет деньги.
Настройки: какие файлы подготовить
Ни модели, ни качества, ни режима тут не выбрать, так что всё решают файлы.
| Поле | Что принимает | Как подготовить |
|---|---|---|
| Видео | MP4, MOV, WebM, от 1 секунды до 10 минут | Лицо крупно и анфас, свет ровный. Лучше, если человек в исходнике тоже говорит: в обоих наших роликах так и было, и губы легли аккуратно. |
| Аудио | MP3, WAV, M4A, AAC, FLAC, OGG, OPUS, до 10 минут | Только голос, без фоновой музыки, гула и эха. Нет записи — озвучьте текст в разделе «Озвучка текста». |
Про длину. Видео длиннее звука укоротится до длины звука. Видео короче звука модель продолжит сама, со всеми сюрпризами из пробы выше. Самый предсказуемый вариант — подрезать оба файла до одной длины заранее, в любом видеоредакторе.
Рука у рта, микрофон перед лицом, профиль, крошечное лицо в общем плане — всё это портит губы у любой нейросети такого рода. Мы такие исходники здесь не проверяли.
Сколько стоит
Счёт идёт по секундам звукового файла с округлением вверх. Видео на сумму не влияет: десятиминутный ролик с фразой на 5 секунд стоит как эти 5 секунд.
| Длина звука | Цена |
|---|---|
| 5 секунд | 25 ₽ |
| 30 секунд | 150 ₽ |
| 1 минута | 300 ₽ |
| 10 минут | 3 000 ₽ |
Длинную запись сначала прогоните кусочком на 5–10 секунд. Сразу станет ясно, устраивает ли мягкая картинка, а заплатите только за кусочек.
Для чего подойдёт
- Перевести ролик: снимали по-английски, а нужен русский, как у Петра.
- Многоминутная лекция, урок или обзор, которые смотрят с телефона: на маленьком экране сглаженное лицо не бросается в глаза.
- Дописать реплику к короткому кадру. Запись может быть длиннее видео, движения модель досочинит.
- Переозвучить героя, снятого видеонейросетью: он говорит по-английски или бормочет непонятное.
- Заменить неудачную фразу: вырезать кусок ролика, перезаписать слова и прогнать через модель только его.
Озвучивать так можно себя или выдуманных героев. С лицом и голосом реального человека — только когда он согласен.
Ограничения и что с ними делать
- Картинка мельче исходника: в обеих пробах высота 464 пикселя, это ниже 480p. Если видео будут смотреть на большом экране, возьмите PixVerse Lipsync (она отдаёт кадр того же размера) или Sync Lipsync 3.0.
- Кожа гладкая, морщины мягче, зубы без чёткого рисунка. Перед публикацией откройте исходник рядом и решите, мешает ли это.
- Если звук длиннее видео, лишние секунды модель заполнит движениями, которых в исходнике не было, и на стыке бывает рывок.
- Управлять длиной нельзя: нет ни повтора видео по кругу, ни выбора отрезка. Это умеет поле Режим синхронизации у Sync Lipsync 2.0.
Соседи по липсинку
ByteDance на сайте представлена ещё двумя нейросетями для губ. Bytedance LipSync берёт файлы тех же форматов и той же длины, но в подсказке к её полю Видео сказано, что ролик выйдет длиной с более короткий файл, так что лишнюю часть звука она отрежет. Volcengine Lip Sync настраивается: режим «Сложная сцена» для кадров со сменой планов, «Очистить голос» для шумной записи, «Зациклить видео». Остальные модели компании разобраны в статье о ByteDance.
| Нейросеть | Цена | Чем отличается | Когда брать |
|---|---|---|---|
| Bytedance LatentSync | 5 ₽/сек. | видео и запись до 10 минут, без настроек, длинную запись не режет | лекции и переводы для телефона |
| Bytedance LipSync | 5 ₽/сек. | видео и запись до 10 минут, ролик по более короткому файлу | лишний звук нужно отрезать |
| Volcengine Lip Sync | 6 ₽/сек. | запись до 10 минут, режим «Сложная сцена», очистка голоса, повтор видео | смена планов, шумная запись |
| Sync Lipsync 2.0 | от 10 ₽/сек. | видео и запись до 10 минут, модели Lipsync 2 и Pro, пять режимов длины, кадр без уменьшения | разговорное видео, крупный план |
| VEED Lipsync | 5 ₽/сек. | видео и запись до 10 минут, без настроек, кадр тоже уменьшается | вторая проба на том же ролике |
| Kling LipSync | 15–30 ₽ | видео и запись от 2 до 60 секунд, кадр не меньше 720 пикселей | одна короткая фраза |
Есть только фотография, а видео нет? Это задача для говорящего аватара: OmniHuman 1.5 и похожие нейросети оживляют снимок под голос.